Context Engine: Live-Werte für KI-Agenten im Prompt
Context Engine erklärt: Warum KI-Agenten Live-Werte statt alter Indizes brauchen und welche vier Werteklassen den Prompt steuern
Ein Support-Agent zahlt eine Erstattung aus, obwohl drei Streitfälle offen sind. Er hätte den Vorgang sperren und an die Deeskalation übergeben müssen.
Ein Anlageberater-Agent nennt einen Portfoliostand, der vor einer Stunde gestimmt hat. Die Suche hat so gearbeitet, wie sie gebaut war, und der Index dahinter war zum Zeitpunkt der Anfrage eine Stunde alt.
Ein Retention-Agent bietet einem Kunden einen Rückhol-Rabatt an, den das Risikosystem gerade eingefroren hat. Der Agent hat den Kunden nach Lifetime-Spend bewertet, während das Risikoteam auf die Nettorückbuchungen geschaut hat.
In allen drei Fällen lagen die richtigen Bausteine schon im Unternehmen, sie kamen nur nicht rechtzeitig in den Prompt. Fahim Zaman nennt das System, das solche Werte zum Kundenstatus im Moment der Anfrage berechnet und in den Prompt setzt, eine Context Engine. Dieser Text folgt seinem Essay vom 28. August 2026 auf dem Blog von Chalk. Zaman arbeitet dort im Product Marketing, und Chalk verkauft genau eine solche Engine; die Codebeispiele weiter unten nutzen entsprechend Chalks Python-Notation.
Was der Agent weiß, steht im Prompt
Ein Sprachmodell hat keine laufende Sicht auf die Welt. Was zu diesem Betrieb, diesem Konto und dieser Sekunde gehört, steht im Prompt oder fehlt. Jede Handlung des Agenten ist eine Schlussfolgerung über den Schnappschuss im Prompt.
Die meisten Fehler entstehen deshalb beim Zusammenbau des Prompts. Neben der Modellqualität zählt, wie nah die Welt im Prompt an dem liegt, was gerade gilt, und ob sich später rekonstruieren lässt, was der Agent gesehen hat.
Heute landen vor allem Dokumente im Kontextfenster, weil die vorhandene Werkzeugkette Dokumente gut holt. Die Werte, die beschreiben, was gerade passiert, bestimmen in laufenden Systemen den Pfad, und genau diese Werte liefert die Kette schlecht.
Drei Wege in den Prompt und der fehlende vierte
Vor den meisten Modellen stehen drei Pfade:
- Ein Vektorindex über Dokumente.
- Ein Memory-Store über den Gesprächsverlauf.
- Tool-Calls: Der Agent liest den Prompt, holt über eine API nach, und das Ergebnis hängt sich an den nächsten Turn.
Keiner der drei Pfade ist für Live-Daten gebaut. Der vierte Weg fehlt in den meisten Architekturen: Werte, die im Moment des Aufrufs berechnet werden.
Retrieval-Infrastruktur macht geschriebenes Wissen auffindbar. Sie berechnet keinen Wert aus Echtzeitdaten im Augenblick einer Entscheidung. In schnell laufenden Betrieben zeigt sich diese Lücke an drei Stellen.
Betriebs- und Weltzustand. Der Agent sieht, was Dokumente, Datenbanken und Semantic Layer sagen. Das ist etwas anderes als der Status dieses Kontos in dieser Sekunde. Aus einem nächtlichen Load lässt sich nicht ablesen, ob der in einem Dokument erwähnte Zahlungskorridor gerade ausgefallen ist.
Situative Bewertung. Der Agent bekommt Rohsätze und soll daraus selbst ableiten. An die abgeleiteten Werte, mit denen der Betrieb denselben Fall seit Jahren bewertet, kommt er nicht heran. Das Risikoteam hat zwei Jahre an einem Chargeback-Modell gearbeitet, und der Agent rechnet trotzdem auf einer nackten Transaktionsliste, weil dieses Modell für ihn nicht erreichbar ist.
Workflow. Niemand sagt dem Modell, welchen internen Pfad es nehmen soll: eskalieren oder schließen, erstatten oder zurückhalten, offenlegen oder nicht. Ohne ein deterministisches Signal improvisiert das Modell, und es hinterlässt dabei keine nachvollziehbare Spur, wie es zu seiner Entscheidung gekommen ist.
Mehr Kontext macht das Modell ungenauer
Der Reflex nach einem Fehler ist, alles ins Fenster zu schieben. Längere Kontextfenster machen das gefühlt billig, während die Trefferquote mit der Menge oft fällt.
Chroma hat 18 Produktionsmodelle getestet, darunter GPT-4.1, Claude 4, Gemini 2.5 und Qwen3. Auf LongMemEval lagen alle Modelle mit einer fokussierten Historie von rund 300 Token höher als mit dem vollen Log von rund 113.000 Token. Schon ein einziger Distraktor im Kontext hat das Ergebnis gegenüber der Variante ohne Ablenkung gedrückt. Quelle: Chroma, Context Rot.
Liu und Kollegen haben in „Lost in the Middle“ die Form dieses Effekts beschrieben: Modelle nutzen Anfang und Ende eines langen Kontexts deutlich besser als die Mitte, und das gilt auch für Modelle, die für lange Kontexte gebaut wurden. Quelle: Liu et al., arXiv:2307.03172.
Applied Compute hat beim Bau juristischer Agenten für Harvey unter anderem begrenzt, wie viele Token ein Tool zurückgeben darf. Solche Eingriffe in die Umgebung haben laut der Fallstudie fast alle getesteten offenen und geschlossenen Modelle verbessert, noch bevor trainiert wurde. Die konkreten Zahlen der Fallstudie vergleichen allerdings das Basismodell mit der per Reinforcement Learning trainierten Fassung: 104 Tool-Calls, 461.000 Token und ein Rubrik-Score von 0,061 vor dem Training, danach 42 Calls, 250.000 Token und 0,803. Quelle: Applied Compute, Fallstudie Harvey.
Was Reasoning-Modellen in solchen Fällen fehlt, sind die wenigen Echtzeitwerte, die sagen, worauf es in diesem Fall ankommt, und selten mehr Text.
Zaman beschreibt denselben Riss bei einem Anbieter für Rechnungsextraktion. Ein Vision-Modell zieht die Positionen aus dem Beleg, ohne die Bestellhistorie dieses Kunden zu kennen, und eine getrennte statistische Schicht fängt unplausible Ergebnisse danach ab. Sieht dort etwas falsch aus, geht die Rechnung an einen Menschen, sodass derselbe Beleg dreimal angefasst wird. Die Bestellhistorie wäre im System berechenbar gewesen, aber das Vision-Modell hat sie während der Extraktion nicht zu sehen bekommen.
Wie zusammengebauter Kontext aussieht
Bevor der Prompt für den Support-Agenten entsteht, löst die Context Engine ein Dutzend Werte für diesen Kunden auf: Zugehörigkeit in Tagen, Tarifstufe, offene Streitfälle in 30 Tagen, Chargeback-Risiko, ob die Jurisdiktion reguliert ist, fehlgeschlagene Zahlungen in der letzten Stunde.
Der letzte Wert steht nirgends festgeschrieben, weil er eine Aggregation über einen Strom von Zahlungsereignissen ist, von denen einige vor vierzig Sekunden eingetroffen sind. Er steht in keinem Dokument und in keiner nächtlich befüllten Tabelle, das Warehouse kennt ihn erst nach dem nächsten Load, und der Agent braucht ihn in dieser Sekunde. Ein Kunde, dessen Karte in der letzten Stunde dreimal gescheitert ist, steht in einer anderen Lage als einer, dessen Karte dreimal im Frühjahr gescheitert ist.
Über diese Werte legt das System fest, welches Werkzeug der Agent sieht und welche Dokumente geholt werden:
- Chargeback-Risiko über der Schwelle und offene Streitfälle: Das Refund-Tool bleibt draußen, der Fall eskaliert.
- Fehlgeschlagene Zahlungen in der letzten Stunde bei kurzer Zugehörigkeit: Die letzten drei Zahlungsversuche werden geholt.
- Regulierte Jurisdiktion: Zwei Tools werden unterdrückt, die Pflichtinformation wird eingefügt.
Beim Modell kommen ein Dutzend Werte an, mehrere davon in diesem Moment berechnet, plus zwei gezielte Retrievals: Transkripte, in denen genau diese Lage zuvor sauber gelöst wurde. Die volle Kontoakte und sechs Monate Tickets bleiben, wo sie sind.
Der Feature-Wert ist die Steuerebene für den Zusammenbau. Der Agent erfährt zuerst, in welcher Lage er steckt, und begründet danach.
Was die Nachbarsysteme leisten
Vektordatenbanken leisten semantischen Recall über Dokumente und rechnen nicht über laufende Systeme. Memory-Schichten halten fest, was gesagt wurde, und dieser Gesprächsverlauf altert, sobald sich der Zustand des Kontos ändert. Knowledge Graphs halten Struktur und Beziehungen, so aktuell wie der letzte Load. Storage-first Feature Stores liefern vorberechnete Werte, deren Frische am letzten Pipeline-Lauf hängt.
Semantic Layer legen fest, was eine Kennzahl bedeutet. AtScale, Dremio oder Cube bilden Warehouse-Tabellen auf Geschäftsbegriffe ab, damit Umsatz überall dasselbe heißt, und lösen Abfragen gegen diese Definition auf.
Glean sucht über Arbeitsplatzsysteme, LangChain verdrahtet Retrieval und Tools, Neo4j hält den Beziehungsgraphen, und Mem0 oder Zep halten den Gesprächsverlauf. Die meisten Teams brauchen mehrere dieser Bausteine gleichzeitig und behalten sie auch neben einer Context Engine.
Keines dieser Systeme berechnet einen Wert aus einem operativen System im Moment der Entscheidung. Retrieval findet weiterhin das Policy-Dokument, und die Context Engine entscheidet, ob genau dieser Kunde es jetzt sehen soll.
Semantic Layer und Context Engine lassen sich koppeln. Der Layer hält die Definition von Churn-Risiko und die zulässige Rechenweise. Heute läuft diese Logik oft gegen Warehouse-Tabellen von gestern Nacht. Mit On-Demand-Auflösung gegen Live-Daten bleiben Governance und Definition unverändert, und die Zahl stammt aus dem Moment der Anfrage statt aus dem Load der letzten Nacht.
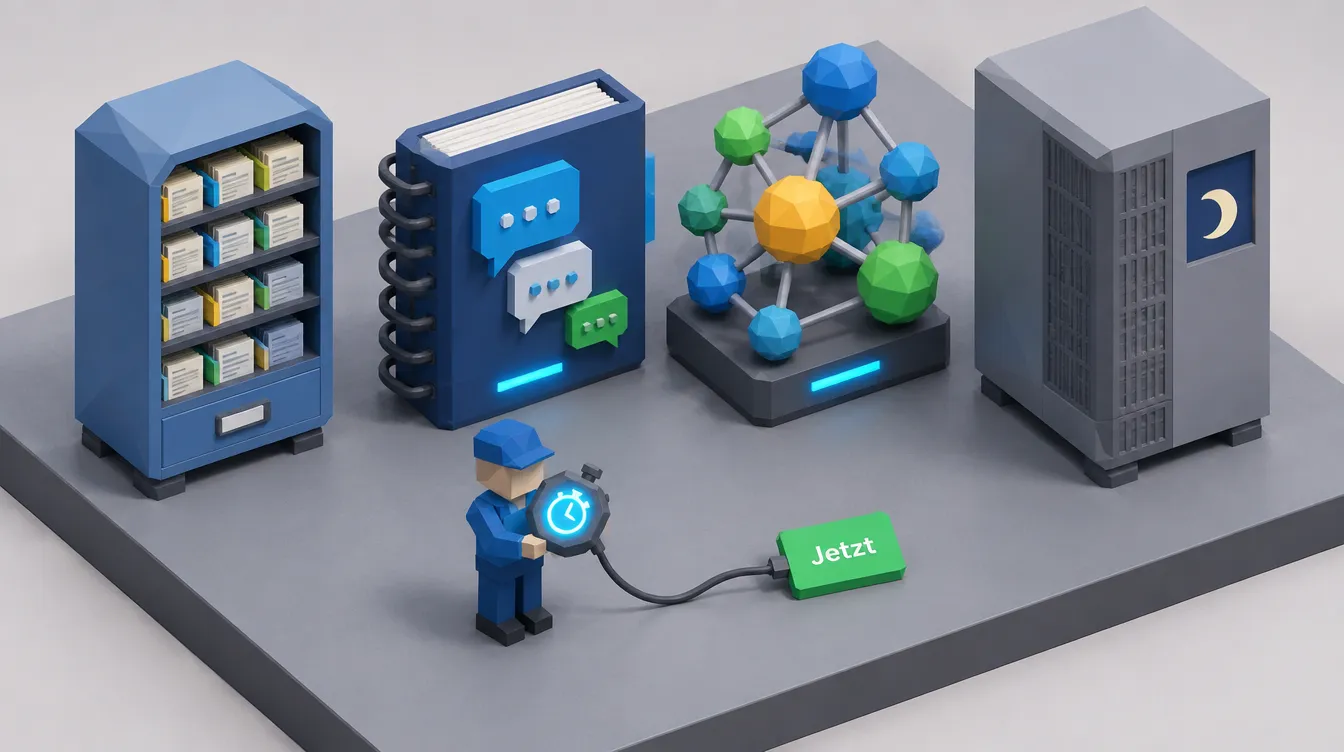
Feature Store, der rechnet statt lagert
Wer einen Feature Store sucht, ist thematisch in der richtigen Ecke. Die erste Generation lagert vorberechnete Werte: Eine Pipeline läuft, schreibt Werte in eine Tabelle, und das Serving liest sie von dort zurück. Das passte, solange der Verbraucher ein Modell war, das planmäßig eine Batch von Zeilen bewertet, und der Frischevertrag am letzten Pipeline-Lauf hing.
Ein Agent entscheidet einmal, über einen Kunden, in einem Moment, und braucht Werte, die noch keine Pipeline berechnet hat. Fehlgeschlagene Zahlungen der letzten Stunde lassen sich nicht vorhalten. Die Antwort um 15:04 und die Antwort um 15:05 sind verschiedene Rechnungen über verschiedene Ereignisse.
Eine Context Engine ist ein Feature Store, der auflöst statt zurückliest. Sie nutzt dieselben Feature-Definitionen, dieselbe Point-in-Time-Korrektheit und dieselbe Konsistenz zwischen Offline und Online, berechnet den Wert aber erst in dem Moment, in dem die Anfrage eintrifft.
Die Primitive stammen aus Feature-Engine und Model Serving und sind hier auf einen anderen Verbraucher gerichtet:
- Agent und Kontext werden gemeinsam in Python definiert, damit Agenten und Modelle dasselbe Wort gleich meinen.
- On-Demand-Auflösung aus Live-Quellen. Ein Wert ist aktuell, weil er bei der Frage berechnet wurde.
- Fenster-Aggregationen, weil „fehlgeschlagene Zahlungen in der letzten Stunde“ Verhalten steuert und in keinem Dokument steht.
- Point-in-Time-Korrektheit, die Trainingsdaten ehrlich gemacht hat und jetzt Evals gegen den Kontext wiederholbar macht, den die Produktion geliefert hat.
- Millisekunden-Latenz, damit die Reasoning-Schleife nicht kriecht.
- Model Serving und Data Lineage, damit festgehalten ist, was der Agent gesehen und getan hat.
- Betrieb in der eigenen VPC, damit sensible Daten das offene Netz nicht kreuzen.
Zaman nennt Mercury, Whatnot und Socure als Betriebe, die Risikoentscheidungen, Empfehlungen, Embeddings und Agenten heute so fahren. Die typische Rechenzeit für einen solchen Wert gibt er mit fünf Millisekunden an.
Welche Werte zuerst
Der Filter für jedes Kandidaten-Attribut ist die Frage, welchen Pfad des Agenten dieser Wert entscheidet. Ändert er nichts daran, was der Agent tut, holt oder verweigert, ist er Dekoration im Prompt.
Vier Klassen lohnen sich, grob in dieser Reihenfolge: zwei Lookups und zwei Rechnungen, wobei die Rechnungen die eigentliche Arbeit sind.
Entity State. Langsam veränderliche Fakten, bei denen Agenten trotzdem regelmäßig danebenliegen: Zugehörigkeit, Tarifstufe, Jurisdiktion, Kontostatus. Sie sind billig zu definieren und gegen die lebende Quelle aufzulösen.
@features
class User:
    id: str
    tenure_days: int
    plan_tier: str
Windowed Counts. Eine fensterbezogene Aggregation läuft zur Anfragezeit über einen Event-Strom. Das Ein-Stunden-Fenster um 15:04 und das um 15:05 sind verschiedene Mengen. Die Antwort ist nirgends gespeichert, deshalb gibt es sie erst, wenn jemand sie zur Anfragezeit berechnet.
@features
class User:
    failed_payments: Windowed[int] = windowed(
        "1h", "24h", "30d",
        expression=_.payments[_.status == "failed"].count(),
        materialization={"bucket_duration": "10m"},
    )
Derived Judgments. Scores und Stufen, die der Betrieb schon rechnet, meist in einem Modell oder einer SQL-Sicht, die kein Agent erreicht. Einmal definieren, damit Agent und Risikosystem nicht auseinanderlaufen.
@online
def get_chargeback_risk(
    failed_1h: User.failed_payments["1h"],
    disputes_30d: User.open_disputes["30d"],
    tenure: User.tenure_days,
) -> User.chargeback_risk:
    return risk_model.predict(failed_1h, disputes_30d, tenure)
Routing Flags. Booleans, die Tools freigeben oder sperren.
@online
def get_refund_eligible(
    risk: User.chargeback_risk,
    disputes: User.open_disputes_30d,
) -> User.refund_eligible:
    return risk < 0.4 and disputes == 0
Der Agent liest hier ein Boolean, das dieselbe Regel nutzt wie das Erstattungssystem, und begründet die Zulässigkeit nicht noch einmal selbst.
Dieselben Werte steuern auch das Retrieval. Löst refund_eligible auf false auf und der Fall geht in eine Ablehnung, helfen zehn frühere Ablehnungen in dieser Produktlinie, die Kunden ohne Eskalation akzeptiert haben, plus die zwei Policy-Abschnitte zu Jurisdiktion und Tarif. Die volle Policy-Bibliothek liefert für diesen Pfad keinen zusätzlichen Halt.
Die meisten Stacks suchen zuerst und begründen danach. Das Modell bekommt einen semantisch ähnlichen Stapel und muss herausfinden, welche Hälfte davon gilt. Wer die Werte zuerst auflöst und danach über ein Regal statt über ein ganzes Warehouse sucht, nutzt denselben Index mit brauchbareren Eingaben, und der Agent verbraucht sein Reasoning-Budget nicht mehr dafür, die Lage zu erraten.
Die drei Fälle vom Anfang
Der Support-Agent hat das Betrugsmodell nie gesehen und musste es auch nicht. Die Ausgabe des Modells ist ein Derived Judgment (chargeback_risk), das der Agent über ein Routing Flag liest: refund_eligible ist false, das Refund-Tool steht nicht in der Tool-Liste, und der Fall eskaliert. Zwei der vier Klassen sind hier verkettet. Der Agent bewertet den Fall nicht besser als zuvor; die Bewertung kommt jetzt fertig aus dem Risikomodell.
Der Berater nannte einen eine Stunde alten Portfoliostand, weil dieser Stand als Entity State aus einem Index kam. Wird dieselbe Entity gegen das System aufgelöst, das sie besitzt, entsteht der Wert erst mit der Frage, und es gibt kein Zeitfenster mehr, in dem die Antwort unbemerkt falsch ist.
Der Retention-Agent, der einen gesperrten Kunden als hochwertig geführt hat, brauchte eine gemeinsame Definition mit dem Risikosystem: value_tier als Derived Judgment, einmal gerechnet und von beiden gelesen, damit Agent und Risikosystem vor dem Kunden nicht zwei verschiedene Aussagen machen.
Ein besseres Modell würde alle drei Fälle auf dieselbe Weise falsch lösen, weil es keine Denkfehler waren: Die nötige Information hat den Prompt zum Entscheidungszeitpunkt nicht erreicht.
Wann eine Context Engine nötig ist und wann nicht
Ein Agent über statische Dokumente, bei dem ein nächtlicher Refresh denselben Stand liefert, braucht diese Schicht nicht.
Eine Context Engine wird relevant, wenn mindestens einer dieser Punkte gilt:
- Der Agent löst Handlungen aus: Erstattung auslösen, Limit freigeben, Sendung freigeben, Fall routen. Eine Handlung auf altem Stand muss der Betrieb später zurückdrehen.
- Die Antwort ändert sich innerhalb einer Session: Kontostand, Bestandszahl, Fraud-Score, Kurs. Bewegt sich ein Wert zwischen der ersten und der dritten Nachricht, kann ein Index ihn nicht halten.
- Aktualität ändert die Bedeutung. Drei fehlgeschlagene Zahlungen in dieser Stunde und drei im Frühjahr sind dieselbe Zahl für zwei verschiedene Lagen.
- Ein anderes System hat schon eine Meinung: Risikomodell, Eligibility-Dienst, Pricing-Engine. Rechnet der Agent eine eigene Fassung, stehen irgendwann zwei widersprüchliche Aussagen vor dem Kunden.
- Jemand wird fragen, was der Agent gesehen hat: regulierte Entscheidungen, Streitfälle, Audits. Rekonstruieren setzt voraus, dass festgehalten ist, was zum Zeitpunkt im Prompt stand.
Auf einen Agenten, der Analysen zusammenfasst, trifft davon selten etwas zu. Auf fast alles, was ein Kundenkonto berührt, trifft mindestens einer dieser Punkte häufig zu.
Die Systeme dafür stammen aus Fraud- und Risiko-Teams, die sich eine alte Antwort nicht leisten konnten: konsistenter Kontext, point-in-time korrekt, unter Last. Sie auf Agenten zu richten, ist der kürzeste Weg zu einem Agenten, der weiß, in welcher Lage er gerade entscheidet.
Quelle: Fahim Zaman, „What is a Context Engine?“, Chalk, 28. August 2026.