KI-Harness: Enterprise-Software mit Coding-Agenten bauen
KI-Harness in der Praxis: wie David Tielke eine Backoffice-Anwendung in 45 Arbeitstagen mit Coding-Agenten neu baute und was Faktor 93 aussagt
Eine Anwendung per Sprachbefehl erstellen klingt bequem. Im Unternehmensalltag kommen allerdings ein paar Dinge dazu: gewachsene Anforderungen, verbindliche Architekturvorgaben, externe Schnittstellen, Tests und Dokumentation. Rechnung und Daten müssen stimmen, und am nächsten Morgen sollte noch jemand verstehen, wie das System funktioniert.
KI kann auch bei umfangreicher Softwareentwicklung große Teile der Arbeit übernehmen. Ein belastbarer Ansatz verbindet fachliche Spezifikationen mit technischen Leitplanken, automatisierten Prüfungen und einer kontrollierten Entwicklungsumgebung. Der zentrale Begriff dafür lautet Harness.
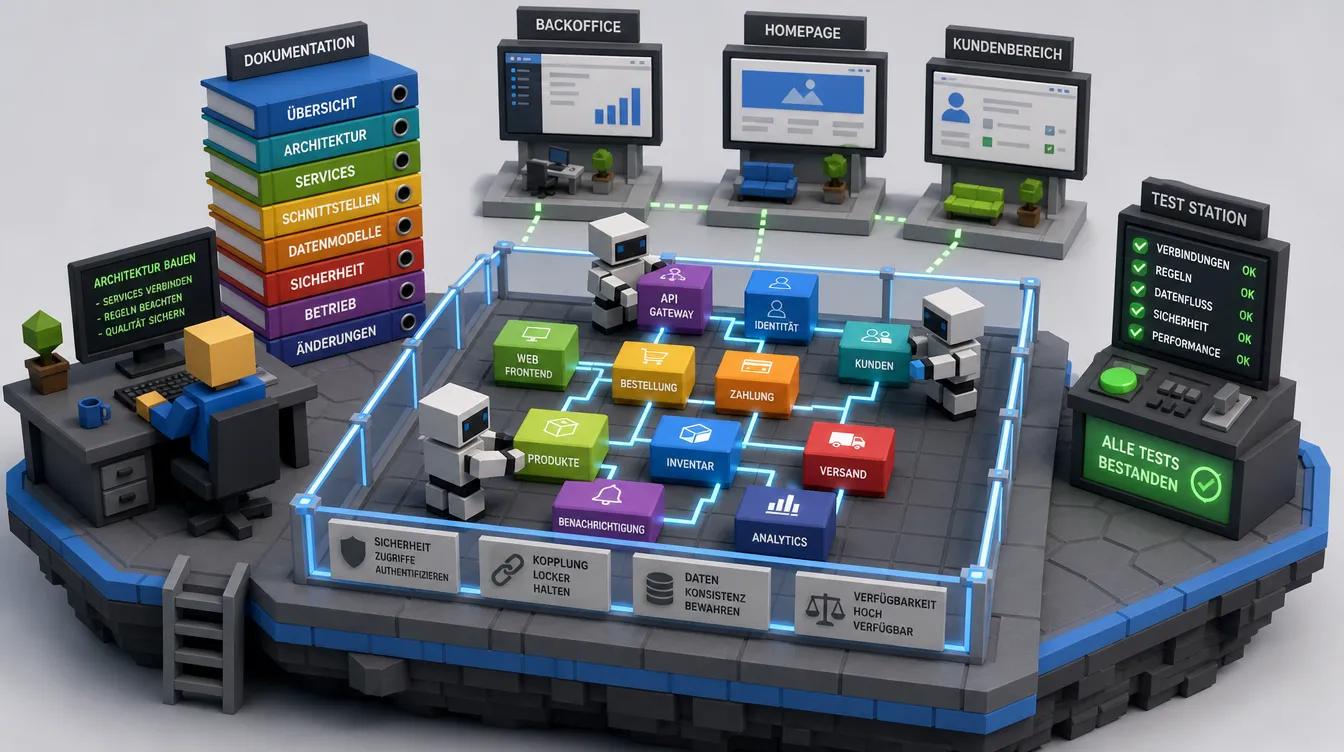
Wie weit dieser Ansatz reichen kann, zeigt ein Entwicklungsversuch von Softwarearchitekt David Tielke. Er hat seine seit 18 Jahren genutzte Backoffice-Anwendung vollständig neu aufgebaut und das Ergebnis im Juni 2026 im Video „Der Moment, der die Softwareentwicklung geändert hat!“ vorgestellt. Der berichtete Aufwand: 45 Arbeitstage, verteilt über mehrere Monate. Heraus kamen zehn Microservices, drei Benutzeroberflächen, umfangreiche Geschäftsprozesse und mehrere Tausend Tests. Alle Zahlen in diesem Beitrag stammen aus Tielkes eigener Darstellung und werden an den passenden Stellen eingeordnet.
Was KI-gestützte Enterprise-Entwicklung umfasst
In der professionellen Softwareentwicklung reicht die Aufgabe weit über das Schreiben von Quellcode hinaus. Anforderungen müssen präzisiert, Architekturentscheidungen umgesetzt, Schnittstellen geprüft und Änderungen nachvollziehbar dokumentiert werden.
Ein KI-Coding-Agent kann in diesem Ablauf mehrere Aufgaben übernehmen:
- Ideen zu fachlichen Anforderungen und Akzeptanzkriterien ausarbeiten.
- Spezifikationen in einzelne Entwicklungsaufgaben zerlegen.
- Tests für das erwartete Systemverhalten erstellen.
- Quellcode innerhalb vorgegebener Architektur- und Codierungsregeln entwickeln.
- Builds, Tests und statische Analysen ausführen.
- Container starten, Protokolle untersuchen und Fehler analysieren.
- Die Entwicklerdokumentation aktualisieren.
Damit verändert sich auch die Zusammenarbeit. Wer bisher jede Codeänderung einzeln angefordert hat, kann dem Agenten zunehmend zusammenhängende Aufgaben übertragen. Wie sich solche Systeme von einer Assistenz zu ausführenden Werkzeugen entwickeln, erläutert auch der Beitrag über KI-Agenten als handelnde Systeme.
Der Aufwand verschiebt sich dabei in die Beschreibung: Anforderungen, Prüfregeln und Arbeitsabläufe müssen schriftlich und eindeutig vorliegen, bevor ein Agent sie zuverlässig befolgen kann.
Ein konkretes Ergebnis: Was in 45 Arbeitstagen entstand
Die Ausgangsbasis des Entwicklungsversuchs war eine ältere .NET-Framework-Anwendung für Rechnungen, Belege und Kundenverwaltung. Sie wurde neu entwickelt und funktional deutlich erweitert. Nach Tielkes Einschätzung erreichte die neue Lösung ungefähr den zwölf- bis fünfzehnfachen Funktionsumfang.
| Bereich | Berichteter Umfang |
|---|---|
| Fachliche Spezifikation | 213 User Stories mit 4.083 Akzeptanzkriterien |
| Backend | 10 Microservices mit 420 API-Endpunkten |
| Datenhaltung | 10 Datenbanken mit 113 Tabellen |
| Geschäftsprozesse | 88 n8n-Workflows |
| Agentenanbindung | 108 über einen MCP-Server verfügbare Werkzeuge |
| Kommunikation | 135 E-Mails innerhalb der n8n-Prozesse |
| Automatisierte Tests | 2.900 API-Tests und 392 Workflow-Tests |
| Quellcode | Rund 420.000 Zeilen |
| Dokumentation | Rund 1.300 Seiten |
Der Umfang zeigt, dass zahlreiche zusammenhängende Funktionen entstanden sind. Die fachlichen Prüfungen und ihre Grenzen zeigen, wie gut die Anwendung ihren Zweck erfüllt.
Berichtete Qualitätswerte
Für Backend und Workflows wurde eine Testabdeckung von 85 Prozent angegeben. Die kritischen Pfade waren nach Tielkes Einschätzung erfasst. Als verbleibende Lücke nannte er Workflows, deren Ausführung durch externe Systeme wie Outlook oder Office ausgelöst wird.
Außerdem wurden innerhalb der eingesetzten Analyse keine strukturellen Schulden festgestellt. Gemeint sind Abweichungen von den festgelegten Architektur- und Designregeln. Die Entwicklerdokumentation wurde als vollständig und durch regelmäßige Neuerstellung aktuell beschrieben.
Diese Aussagen haben einen definierten Geltungsbereich: Die Testabdeckung bezieht sich auf Backend und Workflows, die Strukturanalyse prüft die hinterlegten Regeln. Eine allgemeine Fehlerfreiheit der gesamten Anwendung folgt daraus nicht.
Der Harness: Arbeitsanleitung und Prüfrahmen für den Coding-Agenten
Ein Harness ist in diesem Entwicklungsansatz ein Regel- und Werkzeugrahmen für den KI-Agenten. Er beschreibt, wie der Agent im konkreten Projekt arbeiten soll, und stellt die passenden Prüfwerkzeuge bereit.
Die fachlichen Spezifikationen legen fest, welche Funktionen entstehen sollen. Der Harness ergänzt die technischen und methodischen Vorgaben: welche Architektur gilt, wie codiert wird und wie der Agent die Umgebungen anspricht.
Inhalte eines Harness
- Architekturregeln: Aufbau der Services, Komponenten, Klassen und zulässigen Abhängigkeiten.
- Codierungsrichtlinien: Vorgaben für Quellcode und eingesetzte Technologien.
- Anforderungsverarbeitung: Regeln zur Zerlegung von User Stories in Entwicklungsaufgaben.
- Teststrategie: Ableitung, Struktur, Ausführung und Prüfgegenstände der Tests.
- Umgebungswissen: Repository, Spezifikationsablage, Container und verfügbare Entwicklungsumgebungen.
- Werkzeugnutzung: Auszuführende Analysen und der Umgang mit ihren Ergebnissen.
Im Projekt wurde aus mehreren Harness-Dateien bei jeder neuen Sitzung mit Claude oder Codex ein Systemprompt erzeugt. Der Agent startete dadurch jedes Mal mit denselben Projektvorgaben.
Tielke berichtet, dass neuere Modelle ab Ende 2025 und Anfang 2026 umfangreiche Richtlinien deutlich zuverlässiger einhielten, nach seiner Beobachtung ungefähr ab Claude Opus 4.5. Diese Erfahrung stammt aus einem einzelnen Projekt. Die Regelbefolgung des eingesetzten Modells sollte deshalb an eigenen, konkreten Aufgaben geprüft werden.
Architekturregeln überprüfbar machen
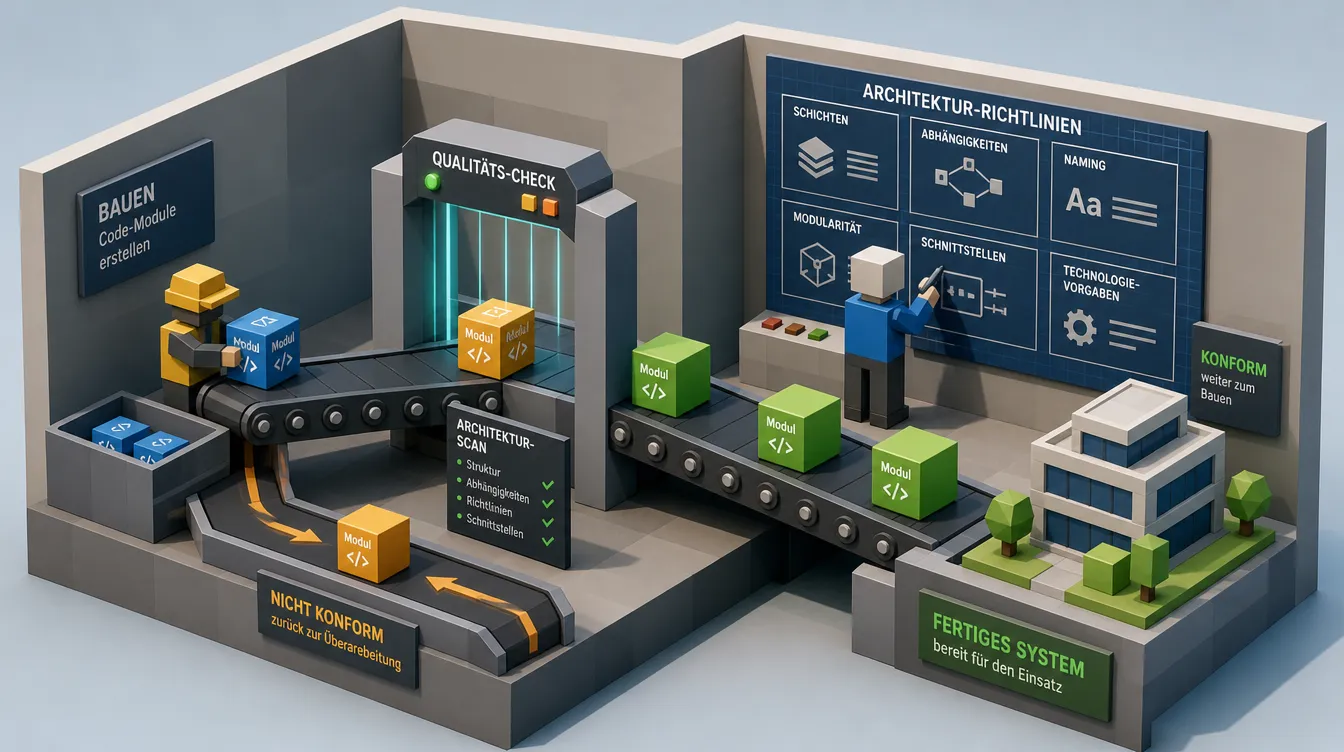
Eine Anweisung wie „Halte dich an unsere Architektur“ lässt viel Spielraum, und eine Prüfung durch das Sprachmodell selbst ist nach Tielkes Erfahrung ungenau und langsam. Im Entwicklungsversuch kamen deshalb NDepend und ReSharper für statische Struktur- und Codeanalysen zum Einsatz. Die verwendete Architekturrichtlinie stammte aus einem Kundenprojekt und umfasste 880 Regeln; hinzu kamen ausführliche Codierungsvorgaben für C# und Blazor.
Nach jeder Codeänderung führte der Agent die Werkzeuge aus und arbeitete anhand ihrer Befunde nach. Die Architekturprüfung lief damit bei jeder Änderung nach denselben Regeln ab.
Blieben Abweichungen, wurde der Harness selbst untersucht: auf unklare Vorgaben, fehlende Regeln und Vorgehensweisen, die nirgends beschrieben waren. Solche Lücken wurden im Regelwerk geschlossen. Tielke nennt diese iterative Verbesserung Harness Correction Development.
Eine Korrektur am Harness wirkt auf jede spätere Aufgabe, die dieselbe Regel berührt. Sie erspart damit viele gleichlautende Einzelhinweise im Prompt.
Ein durchgängiger Ablauf: Von der Idee zur geprüften Änderung
Tielke kam schrittweise zu diesem Ablauf. Er begann mit kleinteiligen Prompts, ergänzte dann den Harness um Prüfwerkzeuge und brachte dem Agenten anschließend bei, Spezifikationen zu zerlegen, Tests aus Akzeptanzkriterien abzuleiten und Ideen in Anforderungen zu überführen. Seine eigene Rolle wanderte dabei vom Entwickler über Architekt und Product Owner bis zum Stakeholder, der Ideen per Sprache einbringt.
Der Ansatz lässt sich als zusammenhängende Entwicklungskette organisieren. Jeder Schritt liefert ein Ergebnis, das im nächsten Schritt verwendet und geprüft werden kann.
1. Ideen sammeln und kritisch durchgehen
Am Anfang stehen fachliche Wünsche: Workshops planen, Termine bestätigen, Angebote freigeben oder Belege verarbeiten. Der Agent hilft, diese Ideen zu strukturieren und offene Fragen zu finden.
Auch Sprache kann als Eingabe dienen. Im Projekt entstand etwa die umfangreiche Workshop-Planung in einem rund vierstündigen Sprachdialog mit Claude, geführt auf der Fahrt zu einem Kunden. Der Agent sollte die Ideen kritisch diskutieren, Rückfragen stellen und Zusammenhänge mit bereits vorhandenen Modulen aufzeigen.
So entsteht aus einem Gespräch zunächst ein geordnetes Ideendokument. Fachliche Entscheidungen und rechtliche Hinweise des Agenten brauchen weiterhin eine verantwortliche Prüfung.
2. Spezifikationen und Akzeptanzkriterien erstellen
Aus den Ideen werden User Stories mit überprüfbaren Kriterien. Diese sollten beschreiben, welches Verhalten das System unter welchen Bedingungen zeigen muss.
Die erzeugten Anforderungen gehen ins Review. Dabei lässt sich prüfen:
- Ist der fachliche Ablauf vollständig beschrieben?
- Sind erwartete Ergebnisse eindeutig?
- Sind Ausnahmen und Fehlerfälle berücksichtigt?
- Passen die Anforderungen zu bestehenden Funktionen?
- Lässt sich jedes Akzeptanzkriterium überprüfen?
Der Agent erhält die Spezifikation erst nach dieser Prüfung zur Umsetzung.
3. Tests aus dem erwarteten Verhalten ableiten
Die Tests werden aus Anforderungen und Akzeptanzkriterien entwickelt. Sie haben damit eine fachliche Grundlage, die unabhängig von der späteren Implementierung formuliert wurde.
Wer Tests ausschließlich aus vorhandenem Code ableitet, riskiert, dessen Verhalten samt Fehlern zu bestätigen.
4. Implementieren und automatisiert kontrollieren
Der Agent zerlegt die Spezifikation in Aufgaben, erstellt den Quellcode und führt die vorgesehenen Tests aus. Anschließend prüfen die Analysewerkzeuge die Einhaltung der Architektur- und Codierungsregeln.
Die Kontrolle umfasst mehrere Ebenen: fachliches Verhalten, Qualität der Tests, Architekturkonformität und korrekte Aufgabenzerlegung. Fehler führen zu einer Überarbeitung der Umsetzung oder des Harness.
5. Dokumentation nachführen
Im Projekt wurde nach kurzer Zeit ein nächtlicher Buildserver-Auftrag eingerichtet, der mit Claude Code die Entwicklerdokumentation komplett neu erstellte. Am nächsten Morgen lag eine aktualisierte Fassung vor, und Tielke schaute nach eigener Aussage häufiger in die Dokumentation als in den Quellcode.
Die nächtliche Neuerstellung zielt auf ein bekanntes Problem: Der Code entwickelt sich weiter, und die Dokumentation hinkt hinterher. Auch generierte Dokumentation braucht einen Qualitätsmaßstab.
Architektur der Anwendung: drei Oberflächen, zehn Services
Die Lösung verbindet drei Oberflächen mit einem gemeinsamen Backend:
- Backoffice: Verwaltung von Kunden, Rechnungen, Belegen und weiteren internen Abläufen.
- Homepage: Workshop-Buchungen, Newsletter-Anmeldungen, Wartelisten und Projektanfragen.
- Kundenbereich: Bestätigung reservierter Termine und Angebote sowie erneuter Download von Rechnungen.
Die Oberflächen greifen über ein mit Traefik umgesetztes API-Gateway auf die Microservices zu. Zu den zehn Services gehören zehn Datenbanken. Geschäftsprozesse werden über n8n orchestriert; Domain Events ermöglichen die Anbindung von Abläufen an Ereignisse aus den Services.
Externe Integrationen umfassen unter anderem Microsoft 365, Google und Trello. Darüber lassen sich E-Mails verschicken, Kalendereinträge und Teams-Besprechungen erstellen sowie Tabellen oder Aufgaben aktualisieren.
Warum hier Microservices zum Einsatz kamen
Tielke hat die Architektur auch gewählt, weil die Anwendung seit Jahren als Beispiel in seinen Architekturworkshops dient und dort bereits in anderen Architekturformen vorliegt. Für den eigenen betrieblichen Bedarf hielt er Microservices ausdrücklich für unnötig.
Harness, Spezifikationen und automatisierte Prüfungen lassen sich als Arbeitsprinzipien auch auf andere Architekturformen übertragen. Die Architekturwahl sollte zu den Anforderungen des jeweiligen Systems passen.
Lokale KI für die spätere Büroautomatisierung
Zusätzlich zur Softwareentwicklung ist ein operativer KI-Einsatz vorgesehen. Ein lokal laufender Hermes-Agent soll über die Anwendungsschnittstellen Rechnungen und Belege bearbeiten sowie Teile der Kundenkommunikation übernehmen.
Ein MCP-Server stellt dafür die verfügbaren Operationen bereit. Als lokale Modellbasis wurde ein Modell aus Alibabas Qwen-Familie gewählt. Der lokale Betrieb soll verhindern, dass sensible Kundeninformationen für diese Büroaufgaben in die Cloud gelangen.
Tielke nennt als Ziel, bis Ende 2026 rund 80 bis 90 Prozent der wiederkehrenden Büroarbeit zu automatisieren. Die getesteten Backend-Schnittstellen sind dafür die Grundlage, weil der Büroagent über sie arbeitet. Der Coding-Agent baut die Anwendung, der Hermes-Agent soll sie später im Betrieb bedienen.
Was API- und Workflow-Tests konkret prüfen
Die Teststrategie konzentriert sich auf das Backend und die Geschäftsprozesse. Unit- und Oberflächentests hat Tielke bewusst weggelassen. Backend und Workflows sind für den späteren operativen Agenten besonders wichtig, weil er über ihre Schnittstellen arbeitet.
API-Tests prüfen mehr als die Antwort
Ein API-Test führt Operationen gegen einen Service mit einer Testdatenbank aus. Er kann anschließend verschiedene Ergebnisse kontrollieren:
- Die zurückgegebene Antwort.
- Die ausgelösten Domain Events.
- Die tatsächlich gespeicherten oder geänderten Daten.
Beim Anlegen eines Kunden lässt sich beispielsweise prüfen, ob der Datensatz korrekt gespeichert wurde und das erwartete Ereignis auf dem Nachrichtenbus erscheint. Eine erfolgreiche HTTP-Antwort allein belegt keines von beiden.
Workflow-Tests prüfen den Ablauf über mehrere Services
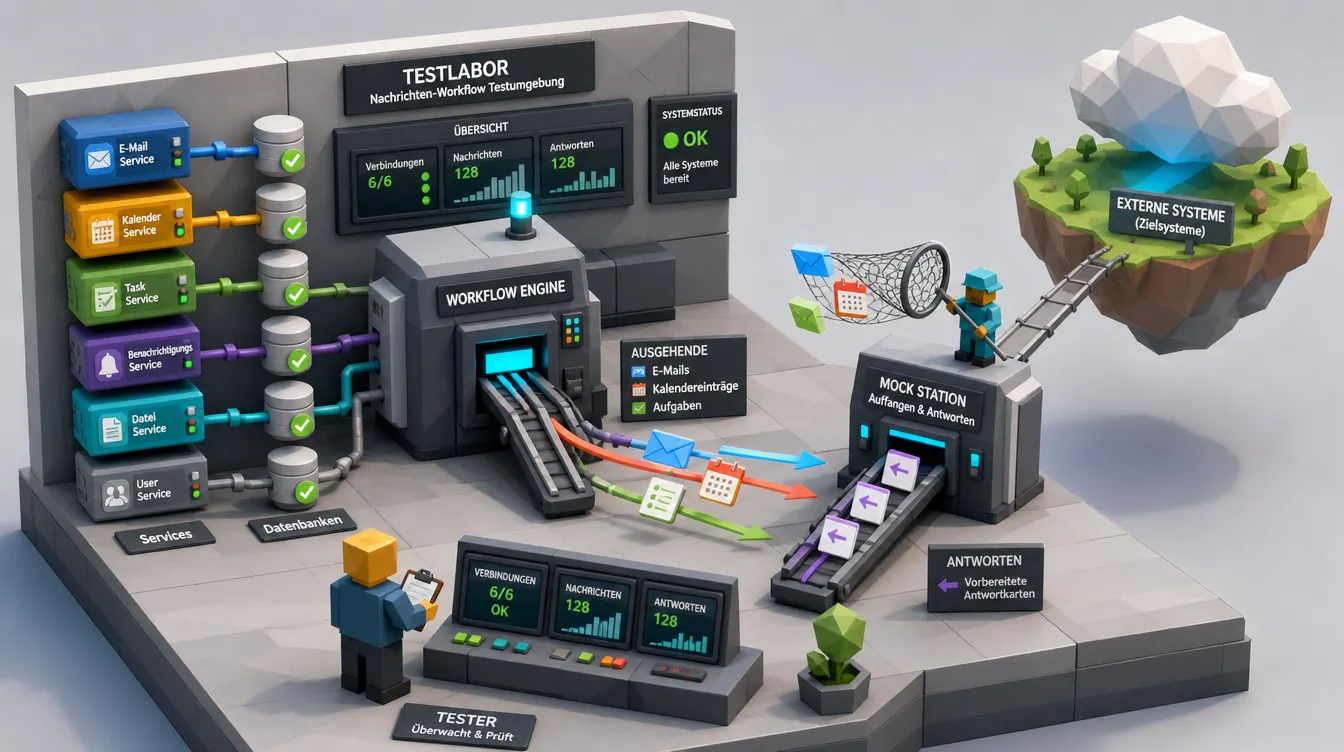
Für Workflow-Tests wird die Umgebung mit den beteiligten Services und Testdatenbanken gestartet. Ein Test führt einen n8n-Workflow aus und prüft sowohl das Ergebnis des Workflows als auch die entstandenen Datenbankänderungen.
Externe REST-Aufrufe, etwa an Microsoft 365 oder Trello, werden in dieser Testumgebung mit WireMock abgefangen und mit vorbereiteten Antworten bedient. Der interne Ablauf lässt sich so kontrolliert prüfen.
Das Verhalten der echten externen Dienste bleibt in diesen Tests ungeprüft. Workflows, die von außen ausgelöst werden, etwa durch Outlook, hat Tielke aus Aufwand-Nutzen-Gründen nicht nachgebildet. Die fehlenden 15 Prozent Testabdeckung gehen nach seiner Angabe auf diese Workflows zurück.
DevOps für KI-Agenten: Ausführen dürfen, Zugriffe begrenzen
Der Coding-Agent braucht ausreichend Zugriff, um seine Arbeit selbst zu überprüfen. Im Projekt standen ihm Quellcode, Spezifikationen, Harness und lokale Docker-Umgebungen zur Verfügung. Er konnte Stände deployen, Container starten und Protokolle auswerten.
Die Infrastruktur bestand aus zwei Entwicklungsrechnern und einem NAS mit Docker. Gitea diente als leichtgewichtiges Repository-System. Ein Build-Agent verteilte neue Stände in getrennte Test- und Produktionsumgebungen auf dem NAS.
Für den SSH-Zugriff galten unterschiedliche Grenzen:
- Testumgebung: weitreichende Möglichkeiten zur Arbeit mit Docker, Containern und Protokollen.
- Produktionsumgebung: eingeschränkte Rechte, im Wesentlichen zum Abrufen von Protokollen für die Fehleranalyse.
Diese Trennung gehört zur Betriebsarchitektur des Agenten. Der Beitrag zum Absichern von KI-Agenten im Entwicklungsprozess beschreibt weiterführende Leitplanken.
Kosten des Entwicklungsversuchs
Für den Versuch wurden 45 Arbeitstage mit jeweils acht Stunden angesetzt. Sie verteilten sich über ungefähr vier bis sechs Monate neben anderen beruflichen Tätigkeiten, meist nachts. Der Wert beschreibt damit den investierten Arbeitsaufwand.
| Kostenposition | Ansatz im Entwicklungsversuch |
|---|---|
| Eigene Arbeitszeit | 45 Tage × 500 Euro = 22.500 Euro |
| KI-Abonnements | 1.620 Euro für zwei Claude-Max-Abonnements, eines über sechs, ein zweites über drei Monate |
| Summe dieser Positionen | 24.120 Euro, im Video als rund 25.000 Euro angegeben |
Der Vollkostensatz von 500 Euro pro Tag ist eine Rechenannahme. Für die Modellnutzung wurden zunächst Codex und später überwiegend Claude eingesetzt.
Warum 27 Milliarden Tokens keine eindeutige Kostenangabe sind
Der berichtete Verbrauch lag bei insgesamt rund 27 Milliarden Tokens auf zwei Rechnern. Ein großer Teil davon waren Cache-Read-Tokens, also bereits verarbeiteter Kontext aus dem Cache.
Tielke rechnete denselben Verbrauch mit den damals aktuellen API-Preisen nach und kam bei Anthropic auf etwa 21.000 Euro. Für DeepSeek V4 Pro als chinesische Alternative nannte er rund 2.000 Euro. Er bezahlte tatsächlich nur die beiden Abonnements.
Diese Varianten hängen von Modell, Tarif, Tokenarten und Nutzungsgrenzen ab. Für eine Unternehmensrechnung kommen außerdem die eigenen Kostenpositionen hinzu. Die TCO-Rechnung für KI im Mittelstand ordnet diese Positionen systematisch ein.
Wie belastbar der Geschwindigkeitsfaktor 93 ist
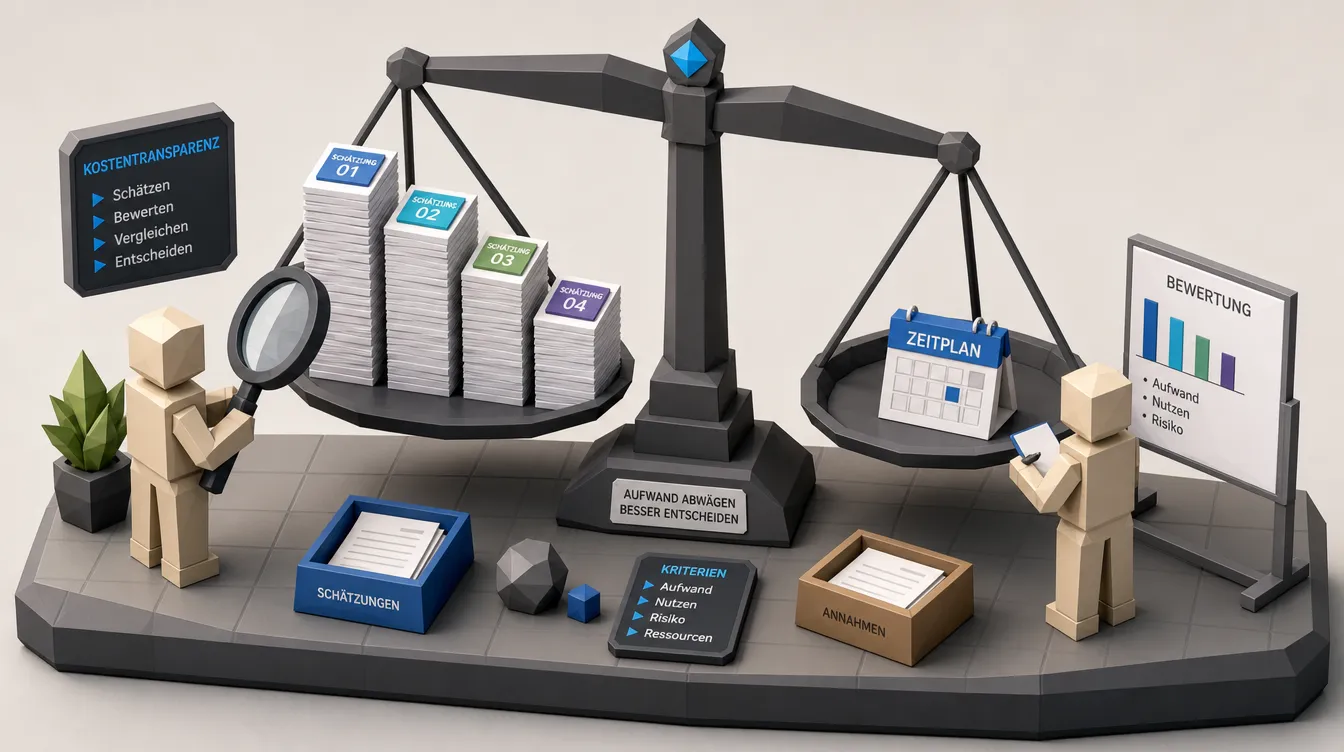
Der Faktor entstand aus dem Vergleich des tatsächlichen Arbeitsaufwands mit Schätzungen für eine konventionelle Entwicklung.
Zwei erfahrene Kundenteams mit fünf und vier Entwicklern schätzten die Umsetzung anhand von Spezifikationen, Architektur, DevOps-Aufbau, Tests und Dokumentationsanforderungen auf 23 beziehungsweise 15 Personenjahre. Hinzu kamen eine Schätzung von Claude und Codex über 20 Personenjahre und Tielkes eigene Schätzung von 18 Personenjahren.
Der Mittelwert betrug 19 Personenjahre. Bei 220 Arbeitstagen pro Jahr ergeben sich 4.180 Personentage. 4.180 geteilt durch die investierten 45 Tage ergibt rund 93.
Der Faktor ist ein schätzungsbasierter Vergleich aus einem einzelnen Projekt. Ein paralleles Team hat denselben Umfang nie tatsächlich umgesetzt. Tielke ging im Video selbst Abschläge durch: Rechnet man Tests und Dokumentation heraus, setzte er 60 an, bei Zweifeln an den Teamschätzungen, für die die Teams einen Tag Zeit hatten, 25. Eine allgemeine Produktivitätsgarantie folgt aus keiner dieser Zahlen.
Auch der Qualitätsvergleich braucht Kontext
Für die vorhandenen Anwendungen der beiden Vergleichsteams wurden ungefähr elf bis vierzehn Prozent Schulden, 25 bis 40 Prozent Dokumentation und 55 bis 70 Prozent Testabdeckung berichtet. Die Projektdokumentation des einen Teams war nach dessen eigener Aussage deutlich vom aktuellen Implementierungsstand entfernt.
Diese Werte stammen aus den bestehenden Anwendungen der Teams und wurden an keinem identischen Parallelprojekt gemessen. Der Vergleich mischt außerdem technische und strukturelle Schulden; strukturelle Schulden im Sinne der Architekturregeln sind enger gefasst.
Die Ergebnisse sind ein guter Anlass, den Ansatz an einem eigenen Projekt zu messen.
Typische Fehler beim Einstieg
- Jede Änderung einzeln dirigieren: Kleinteilige Prompts erzeugen viel Abstimmungsaufwand. Wiederkehrende Vorgaben gehören in den Harness.
- Regeln nur formulieren: Architekturvorgaben brauchen passende Prüfwerkzeuge und einen verbindlichen Ablauf.
- Tests ausschließlich aus Code ableiten: Dadurch können Implementierungsfehler in die erwarteten Testergebnisse wandern.
- Testabdeckung überinterpretieren: Eine Prozentzahl muss zusammen mit Prüfgegenständen und verbleibenden Lücken gelesen werden.
- Produktionsrechte großzügig vergeben: Analysezugriff und Änderungsbefugnisse sollten ausdrücklich getrennt bewertet werden.
- Die Beispielarchitektur übernehmen: Zehn Microservices waren hier auch eine didaktische Entscheidung.
- Dokumentationsmenge mit Qualität verwechseln: Umfangreiche Unterlagen müssen aktuell, verständlich und fachlich korrekt sein.
- Auf Grundlagen verzichten: Gute Architekturregeln setzen Erfahrung mit Architektur, Anforderungen und Tests voraus.
So lässt sich der Ansatz im eigenen Team erproben
Ein sinnvoller Einstieg ist eine überschaubare, fachlich abgeschlossene Funktion. Sie sollte genügend Substanz haben, um Anforderungen, Tests und Architekturregeln gemeinsam zu prüfen.
- Erwartetes Verhalten festhalten: User Story und Akzeptanzkriterien formulieren.
- Den Harness vorbereiten: Architektur, Codierung, Testaufbau und Werkzeugnutzung beschreiben.
- Tests ableiten lassen: Prüfen, ob sie die Akzeptanzkriterien tatsächlich abbilden.
- Implementierung ausführen lassen: In einer begrenzten Entwicklungs- oder Testumgebung arbeiten.
- Ergebnisse kontrollieren: Fachverhalten, Analysebefunde und Dokumentation gemeinsam bewerten.
- Wiederkehrende Fehler im Harness korrigieren: Die verbesserte Anleitung an weiteren Aufgaben erproben.
- Aufwand erfassen: Eigene Arbeitszeit und tatsächliche Modellkosten dokumentieren.
Mit zunehmender Reife kann das Team größere Aufgabenpakete übertragen und auch Ideenarbeit per Sprache erproben. Dabei verschieben sich Tätigkeiten stärker in Richtung Architektur, Anforderungsprüfung und fachlicher Entscheidung. Das Maß dieser Verschiebung sollte sich an den nachgewiesenen Ergebnissen im eigenen Projekt orientieren.
Fazit: Gute Leitplanken machen umfangreiche KI-Entwicklung prüfbar
Der Entwicklungsversuch zeigt einen konkreten Weg, KI über den gesamten Softwarelebenszyklus einzusetzen: Ideen strukturieren, Anforderungen prüfen, Tests ableiten, Code erzeugen, Architektur kontrollieren und Dokumentation nachführen.
Die berichteten 45 Arbeitstage und der schätzungsbasierte Faktor 93 verdienen Aufmerksamkeit. Für die praktische Umsetzung ist vor allem der Aufbau dahinter hilfreich: ein sorgfältig entwickelter Harness, automatisierte Qualitätsprüfungen und klar begrenzte Zugriffe. Tielke selbst führt die Qualität des Ergebnisses auf seine langjährige Erfahrung mit Architektur und Qualitätssicherung zurück, die in den Harness eingeflossen ist.
Der nächste Schritt für ein Team ist eine überschaubare eigene Funktion, die unter diesen Bedingungen entsteht und bei der Aufwand, Testabdeckung und Analysebefunde gemessen werden.