GraphRAG: Wissensgraphen machen RAG präziser
GraphRAG verbindet Wissensgraphen mit RAG. Beziehungen zwischen Personen, Produkten und Dokumenten machen Antworten präziser und nachvollziehbarer.
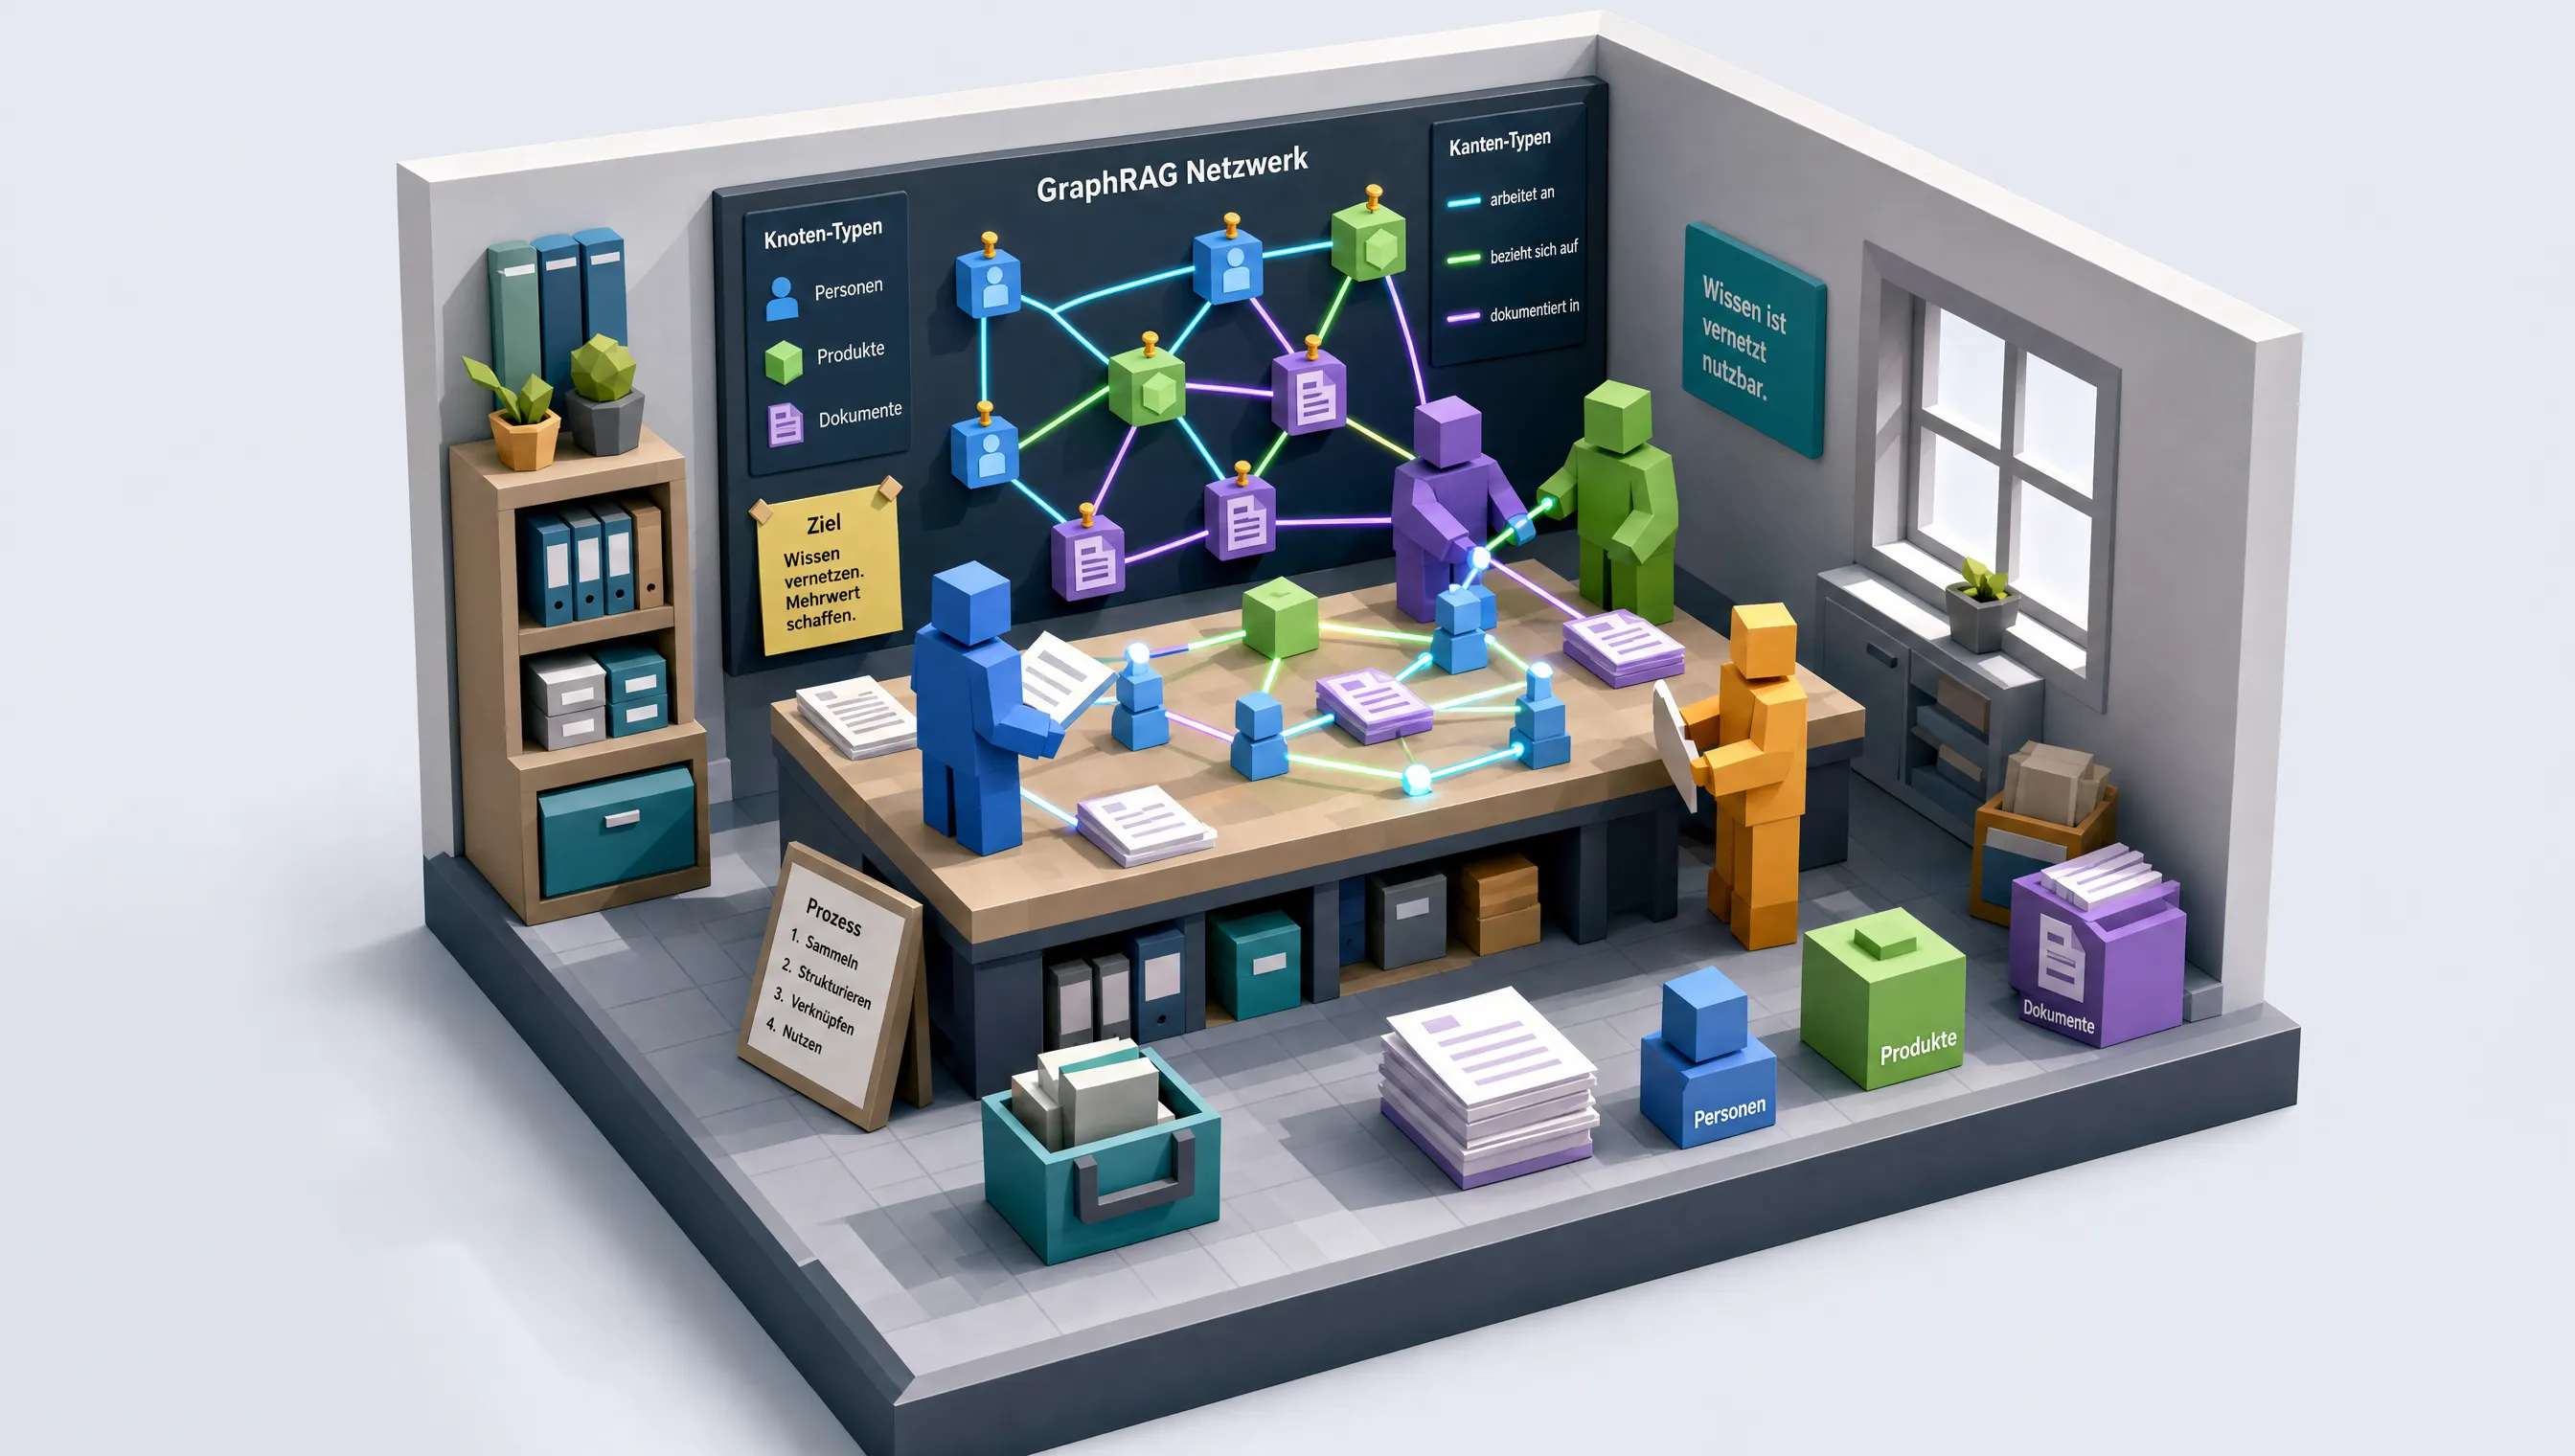
Ein Sprachmodell kann Texte formulieren, Fragen freundlich beantworten und dabei erstaunlich überzeugend danebenliegen. Besonders schnell passiert das bei internem Unternehmenswissen, Spezialthemen oder Informationen, die sich laufend ändern.
Retrieval-Augmented Generation, kurz RAG, hilft: Vor der Antwort werden passende Inhalte aus einer Wissensquelle gesucht und dem Modell als Kontext übergeben. In vielen Projekten besteht diese Suche vor allem aus Vektorsuche. Das ist ein guter Anfang. Bei komplexen Datenbeständen bleibt allerdings viel wertvolles Wissen liegen: Beziehungen zwischen Personen, Projekten, Produkten, Dokumenten, Zuständigkeiten und Fachbegriffen.
GraphRAG erweitert RAG um genau diese Verbindungen. Ein Wissensgraph stellt Informationen als verknüpfte Entitäten dar. So kann ein Assistenzsystem nicht nur einzelne passende Textstellen finden, sondern auch ihr fachliches Umfeld berücksichtigen, Quellen besser nachverfolgen und komplexere Fragen beantworten.
Was ist GraphRAG?
GraphRAG steht für RAG-Architekturen, bei denen Graphdaten oder ein Wissensgraph im Retrieval verwendet werden. Die Grundidee bleibt vertraut:
- Eine Person stellt eine Frage.
- Das System ruft passende Informationen aus einer Datenquelle ab.
- Die gefundenen Informationen ergänzen den Prompt.
- Das Sprachmodell formuliert daraus eine Antwort.
Bei einfachem RAG besteht der abgerufene Kontext oft aus einigen ähnlich klingenden Textausschnitten. Bei GraphRAG kann das System zusätzlich gezielt verknüpfte Informationen laden, etwa:
- die zuständige Person zu einem Projekt,
- weitere Dokumente zu demselben Produkt,
- Fachbegriffe, die mehrere Wissensquellen verbinden,
- den übergeordneten Prozess, zu dem eine Richtlinie gehört,
- vorherige und nachfolgende Abschnitte eines Dokuments,
- Berechtigungen, Abteilungen oder Mandanten als Filter.
Der Graph wird damit zum Wegweiser durch die eigene Wissenslandschaft. Das Modell liefert weiterhin Sprache. Der Graph liefert Struktur, Beziehungen und zusätzlichen Kontext.
Warum reicht Vektorsuche allein oft nicht aus?
Vektorsuche zerlegt Inhalte in kleinere, möglichst zusammenhängende Textabschnitte, sogenannte Chunks. Für jeden Chunk wird ein Embedding erzeugt, also eine Zahlenrepräsentation seiner Bedeutung. Stellt jemand eine Frage, erstellt das System auch dafür ein Embedding und sucht die ähnlichsten Chunks im Vektorraum.
Das funktioniert gut für semantisch ähnliche Fragen. Wer nach „neuen Funktionen in Produkt X“ sucht, muss nicht exakt dieselben Wörter verwenden wie in der Produktdokumentation.
Die Methode hat jedoch Grenzen.
Ein Ähnlichkeitsscore ist noch keine fachliche Relevanz
Ein hoher Vektor-Score zeigt semantische Nähe. Er erklärt nicht automatisch, warum ein Abschnitt zur konkreten Frage passt. Auch der Nutzungskontext einer Person fehlt häufig: Team, Projekt, Rolle, eingesetzter Tech-Stack oder aktuelle Berechtigungen beeinflussen, welche Antwort hilfreich ist.
Text-Chunks verlieren Beziehungen
Ein einzelner Absatz kann erwähnen, dass ein Produkt zu einem Projekt gehört. Ein anderer Absatz beschreibt die verantwortliche Fachabteilung. Ein dritter enthält eine technische Einschränkung. Eine reine Chunksuche findet möglicherweise nur einen Teil dieser Kette.
In einem Graphen lassen sich diese Informationen verbinden und gemeinsam abrufen.
Dokumentgrenzen sind oft künstlich
Unternehmenswissen verteilt sich selten sauber auf einzelne Dateien. Ein Begriff taucht in Handbüchern, Tickets, Richtlinien, Projektunterlagen und Daten aus Schnittstellen auf. Die wirklich nützliche Antwort entsteht oft erst aus der Verbindung dieser Quellen.
Wer die Grundlagen vertiefen möchte, findet in diesem Beitrag eine Einführung in RAG für die Industrie.
Was ist ein Wissensgraph?
Ein Wissensgraph bildet reale oder fachliche Zusammenhänge digital ab. Er besteht aus Knoten, Eigenschaften und Kanten.
- Knoten repräsentieren Dinge wie Mitarbeitende, Dokumente, Produkte, Systeme, Standorte, Technologien oder Projekte.
- Eigenschaften beschreiben diese Dinge, etwa Name, Datum, Status, Beschreibung oder Kennzahl.
- Kanten beschreiben Beziehungen, zum Beispiel „arbeitet an“, „gehört zu“, „verwendet“, „genehmigt“, „beschreibt“ oder „ist zuständig für“.
Ein einfaches Beispiel aus dem Unternehmensalltag könnte so aussehen:
- Das Projekt „Portal 2025“ verwendet das System „Kundenplattform“.
- Die Abteilung „Service“ verantwortet das Projekt.
- Das Dokument „Betriebshandbuch“ beschreibt die Kundenplattform.
- Die Richtlinie „Datenschutz“ gilt für das Projekt und die Plattform.
Eine Frage wie „Welche Datenschutzvorgaben betreffen das Portal 2025?“ kann über diese Beziehungen Informationen aus mehreren Quellen zusammenführen. Dafür muss das System nicht darauf hoffen, dass alle relevanten Sätze zufällig in einem einzigen Chunk stehen.
Wie funktioniert GraphRAG in der Praxis?
GraphRAG besteht üblicherweise aus zwei Arbeitsbereichen: dem Aufbau der Wissensbasis und dem Abruf zur Laufzeit.
1. Daten sammeln und strukturieren
Als Quellen kommen strukturierte, teilstrukturierte und unstrukturierte Daten infrage. Dazu gehören Datenbanken, APIs, Webseiten, PDFs, Wissensdatenbanken oder interne Dokumente.
Bei bereits strukturierten Daten lassen sich Entitäten und Beziehungen häufig direkt übernehmen. Bei Texten braucht es zunächst eine Aufbereitung:
- Dokumente werden in sinnvolle Abschnitte zerlegt.
- Die Abschnitte werden mit Quelle, Reihenfolge und Dokumentkontext gespeichert.
- Embeddings ermöglichen die semantische Suche.
- Ein Sprachmodell kann zusätzlich Entitäten und Beziehungen aus dem Text extrahieren.
Aus einem Absatz über eine Technologie könnten so beispielsweise die Entitäten „Unternehmen“, „Produkt“ und „Technologie“ entstehen. Eine extrahierte Beziehung wäre etwa: „Unternehmen entwickelt Technologie“.
2. Dokumente selbst als Graph modellieren
Auch die Struktur eines Dokuments lässt sich als Graph abbilden. Ein Dokument enthält Abschnitte, Abschnitte enthalten Absätze und Absätze enthalten Chunks. Zwischen benachbarten Chunks können zusätzlich Beziehungen wie „folgt auf“ oder „steht vor“ gespeichert werden.
Das hilft bei einer häufigen RAG-Panne: Die Suche findet einen passenden Ausschnitt, doch die eigentliche Einschränkung steht einen Absatz davor oder die Erklärung direkt danach. Über die Nachbarschaft im Graphen kann das System diesen Kontext gezielt ergänzen.
3. Frage analysieren und passenden Retriever wählen
GraphRAG muss nicht jede Frage mit derselben Methode behandeln. Je nach Fragetyp bieten sich verschiedene Retriever an:
- Vektorsuche: für semantisch ähnliche Textstellen.
- Hybridsuche: kombiniert Vektorsuche mit Volltextsuche.
- Graphabfrage: folgt bekannten Beziehungen und Mustern im Datenmodell.
- Text-to-Query: erzeugt aus einer Frage eine Datenbankabfrage auf Basis des bekannten Schemas.
- Traversal: bewegt sich schrittweise durch Beziehungen und sammelt dabei Informationen.
Für wiederkehrende Fragegruppen kann ein System Fragen kategorisieren und an passende Retriever weiterleiten. Eine Frage nach einer Definition braucht oft andere Daten als eine Frage nach Abhängigkeiten, Verantwortlichkeiten oder Auswirkungen.
4. Kontext erweitern, filtern und antworten lassen
Nach dem ersten Treffer kann der Graph weitere relevante Knoten und Beziehungen liefern. Gleichzeitig lassen sich Filter einsetzen, etwa nach Abteilung, Projekt, Rolle oder Zugriffsrecht.
Erst dieser kontrolliert zusammengestellte Kontext geht an das Sprachmodell. Die Antwort sollte die zugrunde liegenden Quellen und Datenobjekte weiterhin referenzierbar halten.
Ein Beispiel: Von der Frage zur belastbareren Antwort
Angenommen, ein internes System soll die Frage beantworten: „Wer arbeitet an der Einführung von System A und welche Unterlagen sind dafür relevant?“
Eine reine Vektorsuche könnte Absätze finden, in denen „System A“ erwähnt wird. Ein GraphRAG-System kann darüber hinaus folgende Schritte ausführen:
- Es findet den Knoten für System A.
- Es folgt der Beziehung „wird eingeführt in“ zum zugehörigen Projekt.
- Es ruft über „arbeitet an“ die beteiligten Personen oder Teams ab.
- Es folgt „dokumentiert durch“ zu Handbüchern, Anforderungen oder Prozessunterlagen.
- Es berücksichtigt nur Informationen, für die die anfragende Person berechtigt ist.
- Es übergibt die ausgewählten Daten und Textausschnitte als Kontext an das Sprachmodell.
Das Ergebnis kann verständlich formuliert sein und gleichzeitig auf eine klarere Informationskette zurückgehen.
Lokale und globale Fragen: Ein wichtiger Unterschied
Viele RAG-Anwendungen sind gut darin, lokale Fragen zu beantworten. „Was steht in dieser Richtlinie?“ oder „Wann wurde diese Änderung dokumentiert?“ lässt sich oft mit wenigen passenden Chunks beantworten.
Schwieriger werden globale Fragen, die sich über viele Dokumente und Themenbereiche erstrecken. Beispiele:
- „Welche wiederkehrenden Probleme gibt es im Support?“
- „Welche Technologien treten in mehreren Projekten gemeinsam auf?“
- „Welche Themen verbinden diese Forschungsunterlagen?“
- „Wo bestehen übergreifende Abhängigkeiten zwischen Teams?“
Hier kann Community Detection helfen. Dabei werden eng miteinander verknüpfte Bereiche im Graphen als Gruppen erkannt. Aus solchen Communities lassen sich Zusammenfassungen erstellen. Diese Zusammenfassungen liefern einen kompakten Einstieg für übergreifende Fragen, bei denen einzelne Textfragmente zu kurz greifen würden.
Graphalgorithmen können den Datenbestand außerdem mit zusätzlichen Signalen anreichern, etwa Clusterzugehörigkeiten, Zentralität oder Pfade zwischen Knoten. Solche Informationen können für Auswahl und Ranking von Kontext verwendet werden.
Welche Vorteile bietet GraphRAG?
Reicherer Kontext
GraphRAG verbindet Textinhalte mit fachlichen Beziehungen. Das ist besonders hilfreich, wenn eine Antwort mehrere Dokumente, Personen, Prozesse oder Systeme berührt.
Mehr Nachvollziehbarkeit
Bei einer Graphabfrage lässt sich prüfen, über welche Knoten und Beziehungen Kontext ausgewählt wurde. Die Vektorsuche bleibt dabei weiterhin nützlich, doch der Abruf wird um überprüfbare Pfade und Regeln ergänzt.
Bessere Nutzung vorhandener Unternehmensdaten
Unternehmen verfügen meist bereits über Datenmodelle, IDs, Verantwortlichkeiten und Prozesse. Ein Wissensgraph kann diese vorhandene Struktur neben den unstrukturierten Dokumenten nutzbar machen.
Feingranulare Zugriffskontrolle
GraphRAG kann auf Datenbankberechtigungen und Filterregeln aufsetzen. Inhalte, die eine Person nicht lesen darf, sollten gar nicht erst Teil des abgerufenen Kontexts werden. Für produktive Systeme gehören Berechtigungen, Quellenpflicht und Auditierbarkeit in die Architektur. Mehr dazu erläutert der Beitrag Architekturen für sichere RAG-Systeme im Unternehmen.
Flexiblere Suche
Vektorsuche, Volltextsuche, strukturierte Abfragen und Graphtraversierungen können sich ergänzen. Das eröffnet mehr Wege zu einer passenden Antwort, gerade bei heterogenen Datenbeständen.
Wie werden aus Texten Wissensgraphen?
Der Aufbau eines Wissensgraphen aus unstrukturierten Dokumenten war lange aufwendig. Klassische NLP-Verfahren brauchten oft spezielle Modelle, linguistische Regeln und Anpassungen an die jeweilige Domäne.
Sprachmodelle können diesen Prozess erleichtern. Sie erhalten Textabschnitte sowie ein vorgegebenes Schema und extrahieren daraus strukturierte Daten, beispielsweise im JSON-Format.
Ein Schema könnte festlegen:
- Welche Entitätstypen relevant sind, etwa Person, Unternehmen, Standort und Technologie.
- Welche Beziehungen erlaubt sind, etwa „arbeitet bei“, „entwickelt“, „kooperiert mit“ oder „befindet sich in“.
- Welche Eigenschaften zu speichern sind.
Das Modell identifiziert dann potenzielle Entitäten und Beziehungen pro Chunk. Anschließend werden sie mit der ursprünglichen Quelle verknüpft und in den Graphen geschrieben.
Diese Extraktion spart manuelle Arbeit, braucht aber Kontrolle. Sprachmodelle können auch bei strukturierter Ausgabe falsche Beziehungen erzeugen, Entitäten verwechseln oder uneinheitliche Namen verwenden. Gerade in sensiblen Fachdomänen sind Validierung, Normalisierung und Stichproben unverzichtbar.
Typische Fehler bei GraphRAG-Projekten
Alles blind in einen Graphen kippen
Ein großer Datenhaufen wird nicht automatisch zu gutem Kontext. Vor dem Import sollte klar sein, welche Fragen das System beantworten soll. Daraus ergeben sich Entitätstypen, Beziehungen, Quellen und Qualitätsregeln.
Ein zu grobes Datenmodell wählen
„Dokument ist mit Dokument verbunden“ kann ein erster Schritt sein, liefert aber oft wenig Erklärung. Feinere Ebenen wie Abschnitte, Begriffe, Teams, Produkte oder Fachobjekte machen Beziehungen greifbarer.
Zu viele Beziehungen extrahieren lassen
Wenn jede Textstelle mit jeder anderen irgendwie verbunden wird, wächst ein unübersichtlicher Graph. Eine begrenzte, fachlich sinnvolle Auswahl von Beziehungstypen ist meist hilfreicher als maximale Menge.
Vektorsuche komplett ersetzen wollen
GraphRAG baut auf RAG auf und ergänzt Retrieval um Struktur. Semantische Suche bleibt wertvoll, besonders bei offenen Fragen und großen Textbeständen. In vielen Fällen ist ein hybrider Ansatz sinnvoll.
Die Quellenkette verlieren
Jede extrahierte Entität und Beziehung sollte auf ihren Ursprung zurückführbar sein. Sonst wird aus einer Graphansicht schnell eine schwer prüfbare Behauptungssammlung.
Berechtigungen erst am Ende behandeln
Zugriffsrechte sind kein kleines Frontend-Detail. Sie beeinflussen schon den Retrieval-Schritt. Wird unzulässiger Kontext an das Modell gegeben, hilft auch eine spätere Anzeigeprüfung nicht mehr zuverlässig weiter.
GraphRAG und Halluzinationen: Was sich realistisch erwarten lässt
GraphRAG macht ein Sprachmodell nicht automatisch wahrheitsliebend. Das Modell kann weiterhin Informationen falsch zusammenfassen, Quellen missverstehen oder über die bereitgestellten Daten hinausgehen.
Die Architektur verbessert jedoch die Ausgangslage: Das Modell erhält aktuellen, fachlich strukturierten und nachvollziehbaren Kontext. Antworten können mit Quellen verknüpft, Retrieval-Ergebnisse überprüft und Berechtigungen berücksichtigt werden.
Für belastbare Anwendungen braucht es zusätzlich klare Prompt-Vorgaben, geeignete Retriever, Evaluationen und eine saubere Behandlung von Unsicherheit. Praktische Maßnahmen dafür beschreibt auch der Beitrag KI-Halluzinationen im Unternehmen vermeiden.
Für welche Anwendungsfälle eignet sich GraphRAG?
GraphRAG ist besonders interessant, wenn Informationen stark vernetzt sind und Antworten mehr als eine einzelne Quelle benötigen. Typische Einsatzfelder sind:
- Unternehmenswissen: Prozesse, Richtlinien, Teams, Projekte und Systeme.
- Support und Service: Fälle, Produkte, Fehlermuster, Lösungen und zuständige Einheiten.
- Forschung und Entwicklung: Fachbegriffe, Dokumente, Technologien, Publikationen und Zusammenhänge.
- Compliance und Recht: Regelwerke, Anforderungen, Geltungsbereiche und Nachweise.
- Produkt- und Wissensmanagement: Abhängigkeiten zwischen Komponenten, Dokumentation und Verantwortlichkeiten.
Für eine kleine, klar abgegrenzte Dokumentensammlung kann klassisches RAG völlig ausreichen. Der Aufwand für einen Graphen lohnt sich vor allem dort, wo Beziehungen selbst Teil der Antwort sind.
Checkliste: Einstieg in GraphRAG
- Fragen sammeln: Welche Fragen sollen künftig zuverlässig beantwortet werden?
- Datenquellen prüfen: Wo liegen Dokumente, strukturierte Daten, APIs und Berechtigungsinformationen?
- Graphschema entwerfen: Welche Entitäten und Beziehungen werden wirklich gebraucht?
- Quellen verknüpfen: Jeder Chunk, Knoten und jede Beziehung braucht eine nachvollziehbare Herkunft.
- Retrieval kombinieren: Vektor-, Volltext- und Graphsuche passend zum Fragetyp einsetzen.
- Zugriffe früh einbauen: Filter und Berechtigungen vor der Kontextübergabe anwenden.
- Mit realen Fragen testen: Antworten, Quellen, Trefferqualität und Fehlverhalten systematisch bewerten.
- Modellierte Daten pflegen: Entitäten vereinheitlichen, fehlerhafte Beziehungen korrigieren und Änderungen aus den Quellsystemen nachziehen.
Fazit: GraphRAG macht aus Dokumenten vernetztes Wissen
RAG versorgt Sprachmodelle mit externem Kontext. GraphRAG erweitert diesen Kontext um die Beziehungen, die in Organisationen und Fachdomänen ohnehin existieren. Dadurch lassen sich Textausschnitte, strukturierte Daten, Dokumentstrukturen und fachliche Abhängigkeiten gemeinsam nutzen.
Das Ergebnis bleibt eine belastbarere Architektur, keine Wahrheitsgarantie. Es ist eine robustere Grundlage für Systeme, die Antworten auf nachvollziehbaren Unternehmensdaten aufbauen sollen. Besonders bei komplexen Fragen, vielen verknüpften Quellen und hohen Anforderungen an Transparenz bietet ein Wissensgraph einen spürbaren Mehrwert.