LLM-Tokenisierung erklärt: Tokens, Kosten, Kontextfenster
LLM-Tokenisierung bestimmt Kontextfenster, API-Kosten und Modellqualität. Wie BPE, Vokabulargröße und Spezial-Tokens wirken – mit Checkliste für Teams.
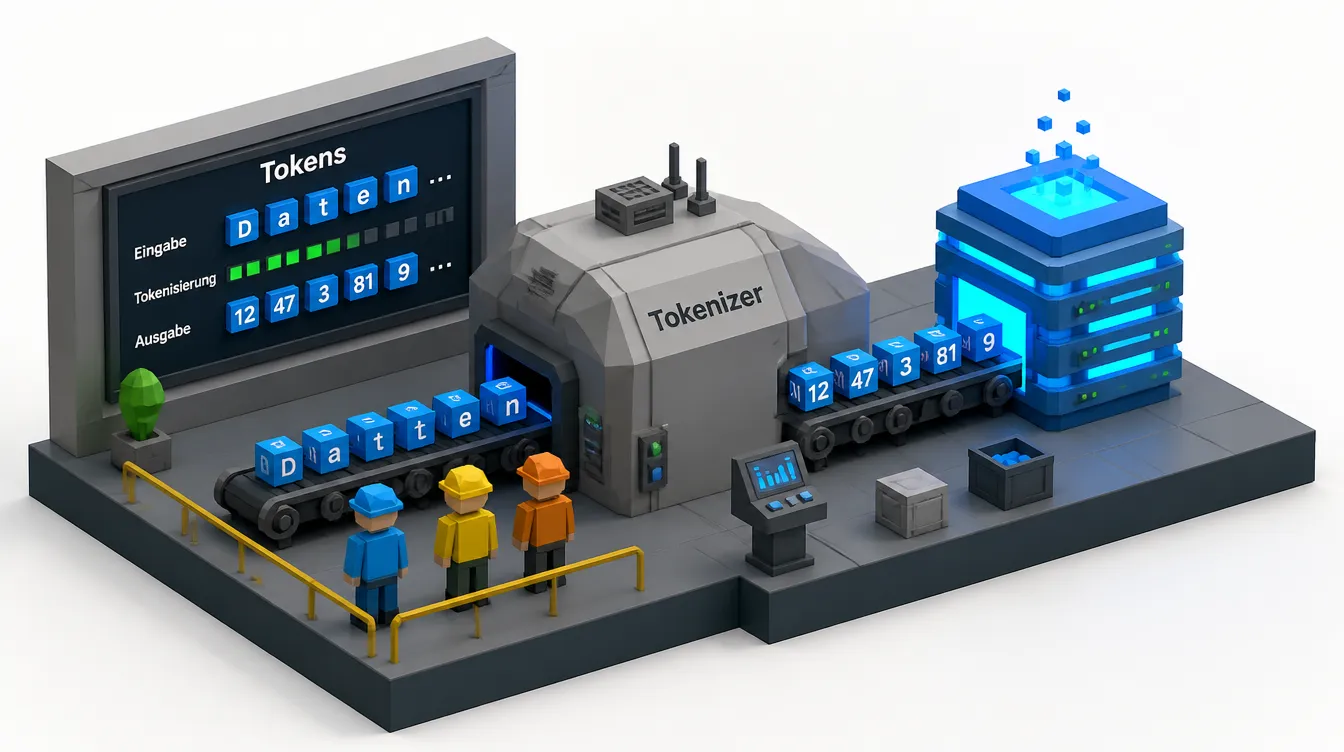
Ein Sprachmodell liest keinen Text so, wie Menschen ihn lesen. Für ein LLM besteht ein Satz aus Zahlenfolgen, den sogenannten Tokens. Aus „Hallo Welt“ werden Token-IDs. Diese IDs verweisen auf Vektoren, die das Modell verarbeitet, um das nächste Token vorherzusagen.
Diese Vorstufe wirkt unscheinbar. Sie beeinflusst jedoch Kontextfenster, API-Kosten, Mehrsprachigkeit, Code-Qualität, Rechenaufwand und einige der seltsamen Fehler, die bei KI-Systemen auftreten können.
Was ist Tokenisierung bei einem LLM?
Tokenisierung ist die Übersetzung zwischen Text und einer festen Menge numerischer Kennungen:
- Encoding: Text wird in Token-IDs zerlegt.
- Decoding: Token-IDs werden wieder zu Text zusammengesetzt.
Ein Token ist dabei weder zwingend ein Wort noch ein Zeichen. Es kann ein einzelner Buchstabe, ein Leerzeichen, ein Satzzeichen, eine häufige Wortendung, ein ganzes Wort oder ein längerer Textabschnitt sein.
Ein englisches Wort kann ein einzelnes Token ergeben. Dasselbe Wort mit vorangestelltem Leerzeichen, anderer Großschreibung oder Satzzeichen kann bereits eine andere Tokenfolge erzeugen. Auch Zahlen werden je nach Tokenizer in unterschiedlich lange Gruppen zerlegt.
Für ein Transformer-Modell sind Tokens die grundlegenden Arbeitseinheiten. Es sieht keine Wörterbuchdefinitionen und keine Zeichenketten im üblichen Sinn. Es erhält Token-IDs, schlägt zu jeder ID einen trainierbaren Vektor nach und verarbeitet diese Vektoren im Modell.
Warum Tokens für LLMs so wichtig sind
Bei Sprachmodellen wird fast alles in Tokens gemessen:
- die Länge eines Prompts,
- die Größe des Kontextfensters,
- die Menge der Trainingsdaten,
- die Kosten vieler API-Anfragen,
- die Geschwindigkeit bei Ein- und Ausgabe.
Ein Kontextfenster von beispielsweise mehreren tausend Tokens bedeutet nicht automatisch mehrere tausend Wörter. Wie viel Inhalt hineinpasst, hängt von Sprache, Zeichensetzung, Code, Sonderzeichen und verwendetem Tokenizer ab.
Wer KI-Anwendungen betreibt, sollte Tokenmengen deshalb vorab mit echten Eingaben prüfen. Besonders bei langen Dokumenten, RAG-Systemen, Chat-Verläufen und großen strukturierten Datenmengen werden aus kleinen Unterschieden schnell relevante Kosten und Qualitätsunterschiede. Ein LLM-Kostenrechner hilft dabei, Tokenpreise und Betriebsmodelle realistisch zu vergleichen.
Von Unicode zu Token-IDs: der technische Weg
Text besteht zunächst aus Unicode-Zeichen. Unicode definiert Zeichen aus vielen Schriftsystemen, etwa lateinische Buchstaben, koreanische Zeichen, mathematische Symbole und Emojis.
Damit Software Text speichern und übertragen kann, wird er codiert. Für moderne Textdaten ist UTF-8 besonders verbreitet. UTF-8 wandelt Unicode-Zeichen in eine Folge von Bytes um. Ein Byte kann einen Wert von 0 bis 255 annehmen.
Ein naiver Tokenizer könnte jedes Byte direkt als Token verwenden. Damit wäre jede mögliche Eingabe darstellbar, weil der Grundwortschatz nur 256 Bytewerte umfasst. Der Preis dafür wären sehr lange Sequenzen. Längere Sequenzen belasten das Kontextfenster und die Attention-Berechnungen eines Transformers erheblich.
An dieser Stelle setzen Verfahren wie Byte Pair Encoding an.
Wie Byte Pair Encoding, kurz BPE, funktioniert
Byte Pair Encoding ist ein verbreitetes Verfahren, um häufige Bytefolgen zu größeren Einheiten zusammenzufassen. Viele GPT-Tokenizer arbeiten auf diesem Prinzip.
Der Ablauf ist schlicht:
- Der Tokenizer startet mit einzelnen Bytes als Grundvokabular.
- Er untersucht Trainingsdaten und zählt benachbarte Tokenpaare.
- Das häufigste Paar wird zu einem neuen Token zusammengeführt.
- Dieser Vorgang wiederholt sich, bis die gewünschte Vokabulargröße erreicht ist.
Angenommen, die Folge A A kommt besonders oft vor. Dann kann ein neues Token entstehen, das genau für diese Folge steht. Danach darf dieses neue Token wiederum Teil weiterer Zusammenführungen werden. So entstehen aus kleinen Einheiten schrittweise längere Textbausteine.
Das Ergebnis ist ein Kompromiss:
- Häufige Muster werden kompakt dargestellt.
- Seltene oder unbekannte Zeichen bleiben über die Bytebasis darstellbar.
- Die Sequenzen werden kürzer.
- Das Vokabular wächst mit jeder Zusammenführung.
Warum die Vokabulargröße ein Kompromiss ist
Ein großes Vokabular kann denselben Text in weniger Tokens pressen. Das schafft mehr nutzbaren Inhalt im Kontextfenster. Zugleich benötigt das Modell größere Embedding-Tabellen und muss beim Vorhersagen über mehr mögliche nächste Tokens rechnen.
Außerdem treten einzelne Tokens bei sehr großen Vokabularen seltener im Training auf. Ihre Vektoren erhalten dann weniger Lernsignale. Sehr lange Tokenstücke können dem Modell auch Zeichenaufgaben erschweren, etwa Buchstaben zählen oder einen Begriff rückwärts schreiben.
Es gibt daher keine universell perfekte Vokabulargröße. Sie ist eine Architektur- und Trainingsentscheidung, die an Datenmix, Modellgröße, Sprachen und Einsatzgebiet angepasst wird.
Tokenizer und Sprachmodell sind zwei getrennte Trainingsstufen
Ein häufiger Irrtum: Der Tokenizer sei bloß ein Teil des trainierten LLMs. Tatsächlich wird er typischerweise vorher separat erstellt.
Der Ablauf sieht vereinfacht so aus:
- Ein Textkorpus trainiert den Tokenizer und seine Zusammenführungsregeln.
- Der fertige Tokenizer wandelt die Trainingsdaten des LLMs in Tokenfolgen um.
- Das Sprachmodell lernt anschließend auf diesen Tokenfolgen.
Die Daten für Tokenizer und Modell müssen nicht identisch sein. Das ist praktisch, kann aber auch Risiken schaffen. Wenn ein Tokenizer ein sehr spezielles Token erzeugt, dieses Token später im Modelltraining jedoch kaum oder gar nicht vorkommt, erhält dessen Einbettung kaum Training. Bei einer Eingabe kann ein solches schlecht trainiertes Token dann unerwartetes Verhalten auslösen.
Der Datenmix des Tokenizer-Trainings beeinflusst zudem direkt, welche Sprache oder welche Formate platzsparend repräsentiert werden. Enthält der Korpus viel englischen Text, entstehen eher viele häufige englische Teilstücke. Enthält er viel Quellcode, können Einrückungen und typische Codefragmente effizienter zusammengefasst werden.
Warum andere Sprachen oft mehr Tokens benötigen
Viele verbreitete Tokenizer wurden mit Datenmischungen trainiert, in denen Englisch stark vertreten ist. Dadurch können englische Wörter und häufige englische Fragmente vergleichsweise kompakt codiert sein.
Eine inhaltlich gleiche Aussage kann in Koreanisch, Japanisch oder einer anderen weniger stark vertretenen Sprache deutlich mehr Tokens beanspruchen. Das hat mehrere Folgen:
- Weniger Text passt in ein festes Kontextfenster.
- Prompts und Ausgaben können teurer werden.
- Das Modell muss längere Tokenfolgen verarbeiten.
- Mehrsprachige Qualität kann unter einem ungünstigen Tokenizer leiden.
Der Umfang der Modelltrainingsdaten in einer Sprache erklärt diesen Effekt nur teilweise. Die Tokenisierung selbst bestimmt mit, wie dicht oder aufgebläht eine Sprache im Modellkontext erscheint.
Warum LLMs bei Buchstaben, Zahlen und Leerzeichen stolpern
Viele vermeintliche Denkfehler von Sprachmodellen haben eine sehr bodenständige Ursache: Die Eingabe wurde in für Menschen unnatürliche Stücke zerlegt.
Buchstabieren und Zeichenmanipulation
Ein Wort kann als einzelnes langes Token vorliegen. Dann ist es für das Modell weniger direkt zugänglich, aus diesem Token jeden Buchstaben abzuleiten, Zeichen zu zählen oder die Reihenfolge umzukehren.
Prompts können helfen, die Aufgabe explizit in kleine Schritte zu zerlegen, etwa:
- Schreibe zunächst jeden Buchstaben einzeln auf.
- Zähle anschließend die gewünschten Buchstaben.
- Erstelle erst danach das Ergebnis.
Das garantiert keine Fehlerfreiheit, reduziert aber die Abhängigkeit davon, ob ein Begriff gerade als ein großes oder mehrere kleine Tokens vorliegt.
Einfache Arithmetik
Auch Zahlen werden oft uneinheitlich zerlegt. Eine Zahl mit mehreren Ziffern kann ein Token sein, aus zwei Tokenstücken bestehen oder in einzelne Ziffern zerfallen. Für schriftähnliche Rechenverfahren ist das ungünstig, weil diese sich auf Einer-, Zehner- und Hunderterstellen beziehen.
Manche Tokenizer begrenzen daher bewusst, wie viele Ziffern zusammengeführt werden dürfen. Das sorgt für konsistentere Zahlendarstellungen und kann Rechenaufgaben erleichtern.
Leerzeichen in Code
In Programmiersprachen wie Python tragen Einrückungen Bedeutung. Wenn jeder einzelne Abstand ein Token ist, wächst eine eingerückte Datei unnötig schnell an. Das verbraucht Kontextfenster und macht die Verarbeitung ineffizient.
Modernere Tokenizer fassen mehrere Leerzeichen häufig zu gemeinsamen Tokens zusammen. Dadurch passt mehr Code in denselben Kontext. Verbesserungen bei KI-gestütztem Programmieren hängen also auch mit einer effizienteren Codierung von Whitespace zusammen.
Regex-Regeln: Warum Tokenizer nicht alles zusammenführen
Ein reines BPE-Verfahren würde häufige Kombinationen unabhängig von ihrer Bedeutung zusammenführen. Das kann zu fragwürdigen Ergebnissen führen, etwa wenn Wörter dauerhaft mit bestimmten Satzzeichen verschmelzen.
Daher teilen GPT-artige Tokenizer Text oft vor der BPE-Verarbeitung in Kategorien auf. Reguläre Ausdrücke können dabei Grenzen zwischen Bereichen setzen, zum Beispiel zwischen:
- Buchstabenfolgen,
- Zahlenfolgen,
- Satzzeichen,
- Leerzeichen,
- gängigen Apostrophformen.
Innerhalb eines solchen Abschnitts darf BPE zusammenführen. Über die vorgegebenen Grenzen hinweg nicht. Diese Regeln beeinflussen die resultierenden Tokens erheblich, einschließlich der Behandlung von Groß- und Kleinschreibung, Leerzeichen und Kontraktionen.
Solche Details sind ein Grund, warum sich Tokenizer verschiedener Modellfamilien nicht beliebig austauschen lassen. Ein Modell ist auf die Token-IDs, Vokabeln und Regeln seines eigenen Tokenizers trainiert.
Spezial-Tokens: Steuerzeichen für Dokumente und Chats
Neben gewöhnlichen Texttokens gibt es Spezial-Tokens. Sie stehen für strukturelle Informationen, etwa das Ende eines Dokuments, Anfang und Ende einer Chat-Nachricht oder weitere interne Markierungen.
Beim Training können Dokumente beispielsweise durch ein Ende-des-Texts-Token getrennt werden. Das Modell lernt dadurch, dass nach diesem Marker ein neuer, unabhängiger Text folgen kann.
In Chat-Systemen strukturieren Spezial-Tokens häufig Rollen und Nachrichtenblöcke. Sie helfen dem Modell, Benutzeranweisungen, Antworten und Systemvorgaben auseinanderzuhalten.
Für Entwickler ergibt sich daraus eine Sicherheits- und Robustheitsfrage: Nutzereingaben sollten nicht versehentlich als interne Steuersequenzen behandelt werden. Spezial-Tokens gehören zur Modell- und Anwendungsarchitektur, nicht in unkontrollierte Textpfade.
Warum ein abschließendes Leerzeichen problematisch sein kann
Ein einzelnes Leerzeichen am Ende eines Prompts wirkt harmlos. Bei manchen Tokenizern ist es jedoch ein eigener, ungewöhnlicher Tokenzustand.
Häufig bilden Leerzeichen zusammen mit dem folgenden Wort ein Tokenstück. Wird das Leerzeichen vorher einzeln vorgegeben, kann die Eingabe in eine Tokenfolge geraten, die im Training selten vorkam. Die anschließende Vervollständigung wird dadurch weniger verlässlich.
Praktische Regel für Completion- und Prompting-Workflows: Unbeabsichtigte Leerzeichen am Ende entfernen. Gleiches gilt für unvollständige Wortfragmente, wenn eine Anwendung Token für Token weitergeneriert.
Tiktoken und SentencePiece im Vergleich
Zwei verbreitete Werkzeuge stehen exemplarisch für unterschiedliche Tokenizer-Ansätze.
Tiktoken
Tiktoken ist eine Bibliothek für Tokenisierung im GPT-Umfeld. Der Ansatz basiert auf Byte-Level-BPE: Text wird als UTF-8-Bytefolge betrachtet, auf der anschließend Zusammenführungen angewendet werden.
Vorteile dieses Prinzips:
- Jede Texteingabe bleibt über Bytes darstellbar.
- Es passt gut zu heterogenen Internetdaten, Emojis und vielen Schriftsystemen.
- Die Tokenisierung für die Anwendung kann effizient erfolgen.
Tiktoken dient vor allem zur Nutzung bereits trainierter Tokenizer. Für eigene Tokenizer-Trainings braucht es zusätzliche Implementierung oder ein anderes Werkzeug.
SentencePiece
SentencePiece wird von vielen Modellfamilien verwendet und unterstützt sowohl Training als auch Tokenisierung. Es kann ebenfalls BPE nutzen, arbeitet dabei jedoch typischerweise auf Unicode-Codepoints und bringt zahlreiche Konfigurationsoptionen mit.
Bei seltenen Zeichen kann SentencePiece je nach Einstellung ein Unbekannt-Token verwenden oder über UTF-8-Bytes zurückfallen. Der Byte-Fallback verhindert, dass viele unterschiedliche Zeichen in derselben unbekannten Kennung landen.
Die große Zahl an Optionen erfordert Sorgfalt. Einstellungen zu Normalisierung, Zeichenabdeckung, Leerzeichen, Ziffern, Satzlängen und Spezial-Tokens verändern die resultierende Tokenisierung. Wer einen vorhandenen Modelltokenizer reproduzieren möchte, sollte dessen Konfiguration möglichst genau übernehmen.
Tokenisierung und RAG: Warum Chunking allein nicht reicht
In RAG-Anwendungen wird häufig über Textabschnitte, Dokumentgrenzen und Chunk-Größen gesprochen. Dahinter steckt immer auch eine Tokenfrage. Ein Abschnitt mit „500 Zeichen“ hat je nach Sprache und Inhalt eine sehr unterschiedliche Tokenlänge.
Bei der Planung sollten Teams daher in Tokens messen, denn das Modell verarbeitet genau diese Einheit. Das betrifft die Größe einzelner Retrieval-Chunks, die Zahl der Quellen im Prompt und die verbleibende Kapazität für die Antwort. Grundlagen dazu erklärt der Beitrag RAG für die Industrie.
Eine gute Tokenplanung ersetzt keine Qualitätskontrolle. Sie schafft jedoch die Voraussetzung dafür, dass relevante Quellen vollständig im Kontext landen und das Modell nicht vor der wichtigen Passage abgeschnitten wird. Für belastbare Antworten braucht es zusätzlich Quellenbezug und passende Prüfmechanismen, wie im Leitfaden zu KI-Halluzinationen im Unternehmen beschrieben.
Praktische Checkliste für Teams und Entwickler
- Tokenizer des Modells verwenden: Token-IDs anderer Tokenizer sind inkompatibel.
- Tokenzahl mit realen Daten testen: Besonders bei Deutsch, weiteren Sprachen, Tabellen, JSON und Code.
- Kontextbudget reservieren: Ein Prompt darf das Kontextfenster nicht vollständig ausfüllen. Die Ausgabe braucht ebenfalls Platz.
- Trailing Whitespace bereinigen: Abschließende Leerzeichen können ungünstige Tokenfolgen erzeugen.
- Strukturierte Formate messen: JSON, YAML, Markdown und CSV können sehr unterschiedliche Tokenkosten verursachen.
- Spezial-Tokens schützen: Interne Marker klar von Nutzereingaben trennen.
- Mehrsprachigkeit prüfen: Dieselbe Aufgabe in den tatsächlich genutzten Sprachen tokenisieren und vergleichen.
- Eigene Tokenizer sorgfältig trainieren: Trainingskorpus, Vokabulargröße, Codeanteil und Sprachmix wirken sich langfristig aus.
Kann man LLMs ohne Tokenizer bauen?
Grundsätzlich ist die Idee attraktiv: Ein Modell könnte direkt auf Bytefolgen arbeiten und die oft komplizierte Tokenisierungsschicht umgehen. Das würde einige Probleme mit unbekannten Zeichen, Teil-Tokens und sprachspezifischer Verdichtung entschärfen.
Der Haken liegt in der Sequenzlänge. Bytefolgen sind viel länger als BPE-Tokenfolgen. Klassische Transformer-Architekturen müssten diese längeren Eingaben effizient verarbeiten können. Ansätze für tokenisierungsfreie Modelle werden untersucht, sind aber kein allgemein etablierter Standard für große Sprachmodelle.
Fazit: Tokens sind ein Teil der Modellqualität
Tokenisierung wirkt bis in die Modellqualität hinein. Sie legt fest, wie dicht Text, Code, Zahlen und Sprachen im Kontext eines LLMs erscheinen. Sie beeinflusst Kosten, verfügbare Kontextlänge und die Robustheit bei Zeichenaufgaben oder ungewöhnlichen Eingaben.
Für den praktischen Einsatz genügt meist ein klarer Grundsatz: In Tokens planen, mit dem passenden Tokenizer messen und reale Eingaben testen. Wer Tokenisierung früh in Architektur, Kostenrechnung und Qualitätsprüfung einbezieht, vermeidet viele Probleme, die später wie unerklärliche Modellschwächen aussehen.